SenseNova Loop-9B 正式版:以更少參數實現更深層運算
商湯科技正式發布 SenseNova Loop-9B。該模型延續 Preview 版本對參數效率的探索:透過 Loop 結構重用模型層的參數,並結合流形約束超連接(mHC),以約9B參數規模擴展運算深度,支援複雜推理、程式碼、工具調用及多模態任務。受惠於 Loop 的高效循環結構,官方 4bit 量化後的權重僅約 4.9GB,部署所需顯示記憶體最低可低於 10 GB,能顯著拓闊可部署的硬件範圍,讓顯示記憶體有限的晶片亦有望達到領先 27B 級別模型的效能。
自 Preview 發布以來,我們收到社群對模型使用、推理部署及生態系統適配的關注與意見。此次正式版沿用 Loop 與雙流 mHC 架構,進一步優化模型在智能體、程式碼及數據分析任務中的表現,並持續探索循環運算對提升模型能力的作用。
SenseNova Loop-9B 的總參數量約為 9B。模型透過將共享的中間層執行兩次,把 32 個實體解碼器層擴展為 56 次層運算;支援文字、圖像輸入及文字輸出,上下文長度最高可達512K tokens。在智能體及數據分析評測中,模型展現出與 Qwen3.8-27B 相當的競爭力:NL2Repo 得分為 41.36,接近後者的 44.60;AIDABench 得分為 65.31,高於後者的 65.01。
模型亮點
共享循環模組:將第 4–27 層組成共享權重的循環模組,並執行兩次,使模型在一次前向傳播中完成 56 次解碼器層運算。
雙流 mHC:透過可學習映射,對循環模組中的兩條殘差流進行資訊路由與融合。
混合注意力:解碼器以四層為一組,採用三層線性注意力與一層全注意力相結合的配置。
長上下文多模態:訓練方案涵蓋文字、圖像、程式碼及工具調用軌跡,上下文長度最高擴展至 512K tokens。
適合低資源私有化部署:採用 4bit 權重量化及 8bit KV 快取時,256K 長上下文推理所需的顯示記憶體約為 15 GiB,有助降低本機及私有化部署門檻。
官方量化版於發布首日提供:模型發布當日同步提供官方AWQ 4bit 量化版本,方便使用者快速部署。
SenseNova Loop-9B 已開放模型權重及相關程式碼,供開發者與研究人員下載、部署及探索。
模型能力:正式版較 Preview 進一步提升
我們針對通用智能體、程式碼及數據分析等任務,對 SenseNova Loop-9B 正式版進行評測,並與 Preview 版本及Qwen3.8-27B 等模型比較。
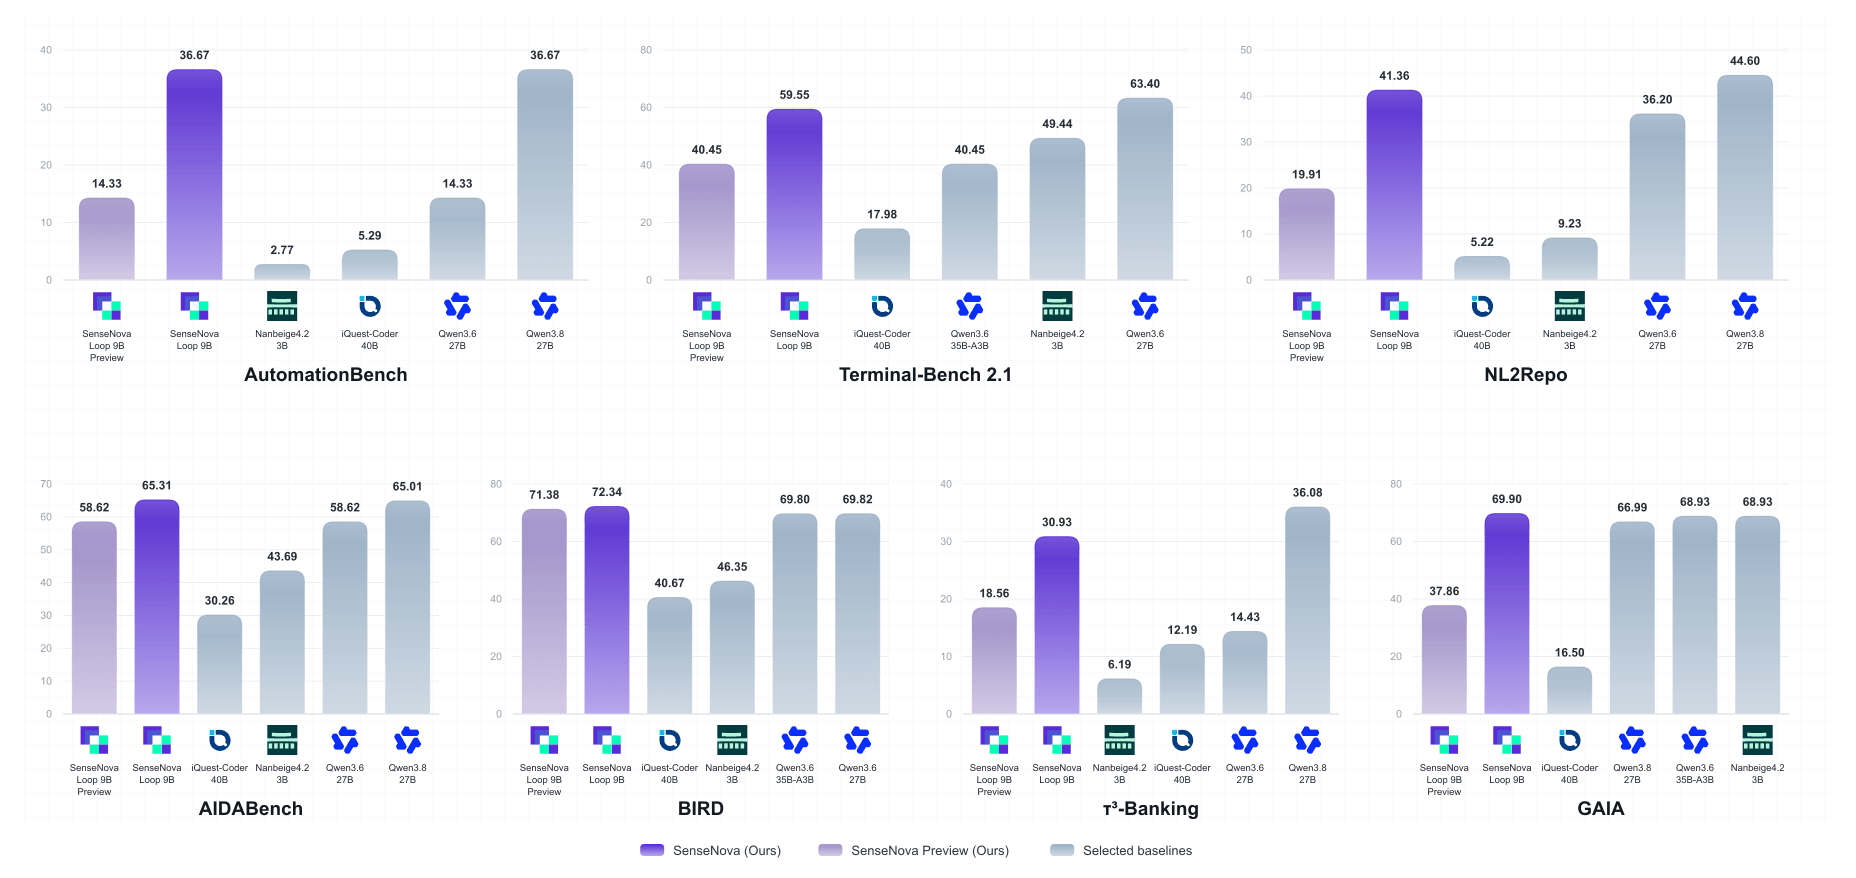
評測結果顯示,SenseNova Loop-9B 正式版在多個評測榜單上的表現較 Preview 版本明顯提升;並以約 9B 參數規模,展現出媲美 Qwen3.8-27B 的效能。
模型表現
以下為 SenseNova Loop-9B 正式版在實際場景中的表現。(註:下方展示案例均由本模型在 Codex / Hermes 中,經 1–4 輪使用者互動完成。)
製作《失真頻率 DISTORTION FM》音樂節動態海報網頁
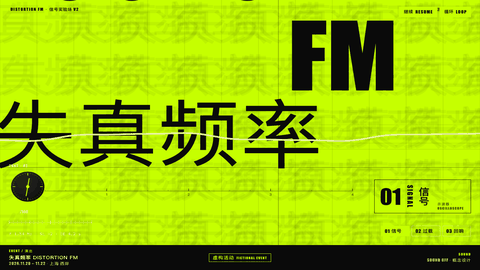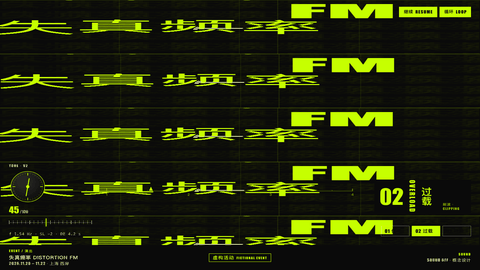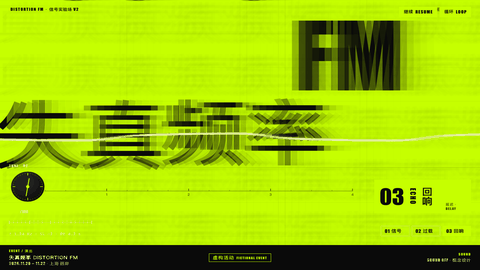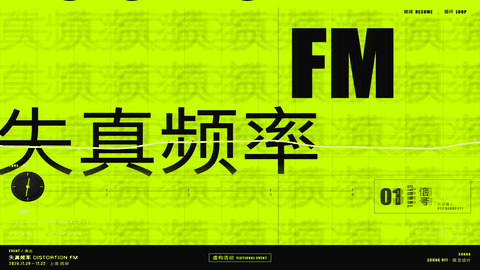
提示詞:製作《失真頻率 DISTORTION FM》音樂節動態海報網頁。以巨大窄體標題佔據畫面,採用酸橙綠、黑、暖白三色;字體擠壓、錯位、重組,背景文字前移遮擋畫面後揭示新章節。點擊三個演出章節,切換富有節奏的全螢幕構圖,提供循環播放及暫停功能。小字號中文演出資訊須清晰,虛構活動標註為概念設計。參考 @url:https://tympanus.net/Development/KineticTypePageTransition/ 的文字轉場概念,原創實作。
製作「字形接力 TYPE RELAY」實驗字體展互動網站
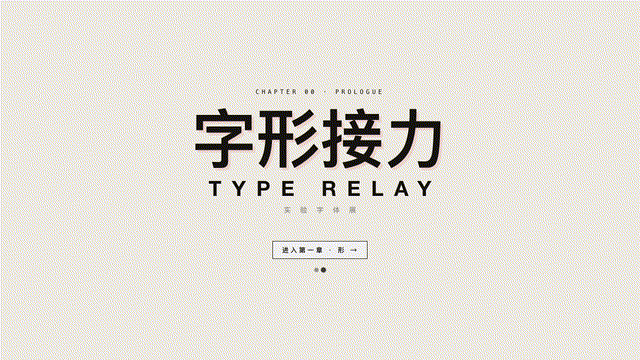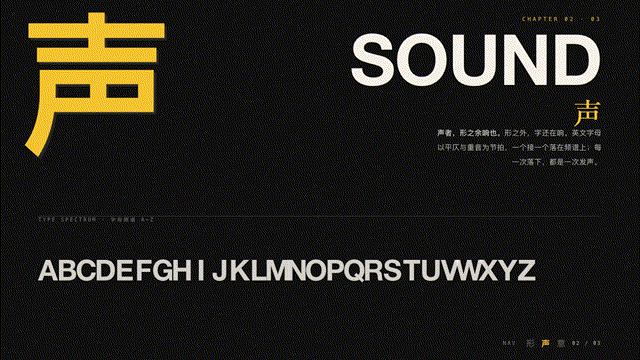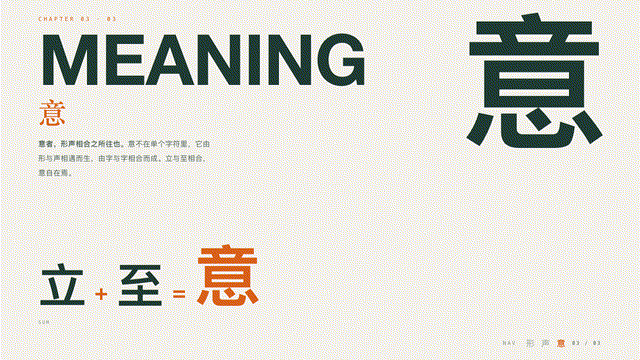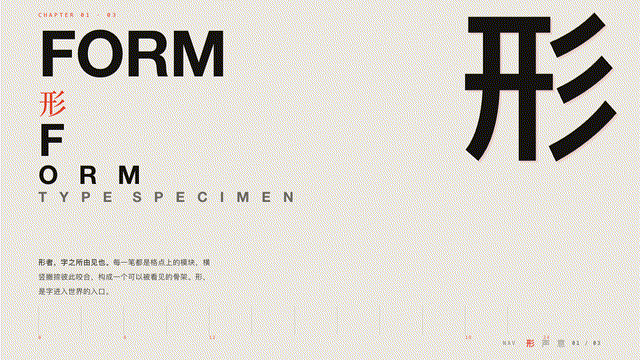
提示詞1:製作一個名為「字形接力 TYPE RELAY」的實驗字體展互動網站。讓文字本身成為頁面切換的主角:使用者在「形」「聲」「意」三個展覽章節之間切換時,巨大的漢字與英文字母透過有節奏的移動、尺度變化及重新編排,將上一章自然帶入下一章,猶如一場連續的字體表演。每章均有自身的內容、色彩與構圖,既具鮮明實驗性,亦保留清晰的閱讀層次。請自行設計原創視覺語言、轉場編排及互動細節,製作可在瀏覽器實際操作的完整網頁。
提示詞2:請按以下詳細要求繼續製作《字形接力》,細化視覺與轉場:
製作原創實驗字體展網站「字形接力 TYPE RELAY」,包含「形、聲、意」三個可切換章節。核心體驗是一場由巨大文字驅動的全螢幕轉場,具有前衛平面設計及動態字體短片的質感。
每個章節均須有完整且不同的構圖:超大中英文標題、簡短展覽文案、具視覺張力的主圖或原創圖形,以及精簡導覽。運用鮮明的字號對比、局部超出畫面的裁切、不對稱布局及精準留白建立層次,具體配色與字體組合由你設計。
點擊章節後的轉場分為三個階段:
當前內容短促退場,章節關鍵詞迅速放大,同一詞語形成多行排印,逐漸鋪滿螢幕。
各行文字以錯開的時序及不同方向掠過畫面,形成有節奏的遮擋;背景色同步接管畫面,於遮擋最充分時完成章節切換。
文字陣列持續移動並退出,新章節的主標題、主視覺及說明依次顯現,最後穩定於清晰可讀的版面。
轉場約 1.5–2 秒,須有明確的蓄勢、加速與收束,避免等速滑動。文字的移動軌跡、行距、尺度及前後層次須經過編排,既有強烈衝擊,亦能呈現秩序。切換過程須保持畫面連續,下一章不應突然閃現。
三個章節共用一套視覺語言,但分別體現結構、節奏及留白的差異。支援前後切換,連續點擊時須妥善處理動畫狀態,視窗尺寸變更後仍保持完整構圖。直接製作可在瀏覽器操作的網頁。
製作《海岸線以外》攝影雜誌式HTML短篇網頁
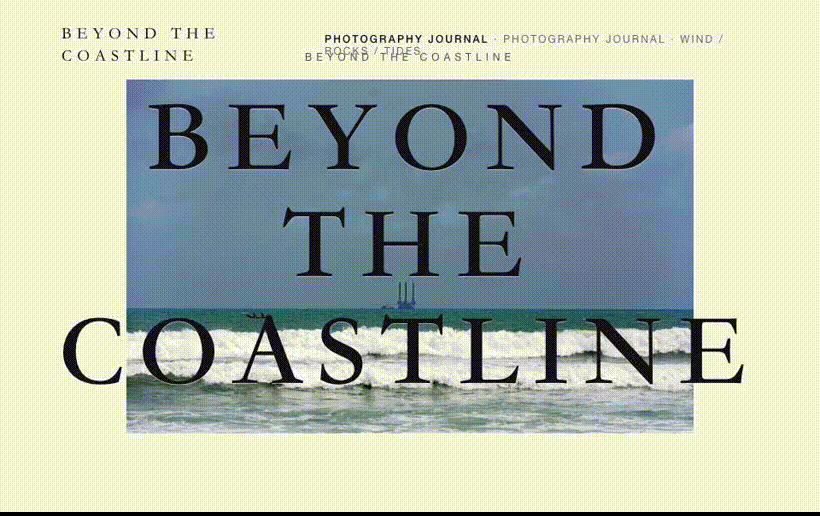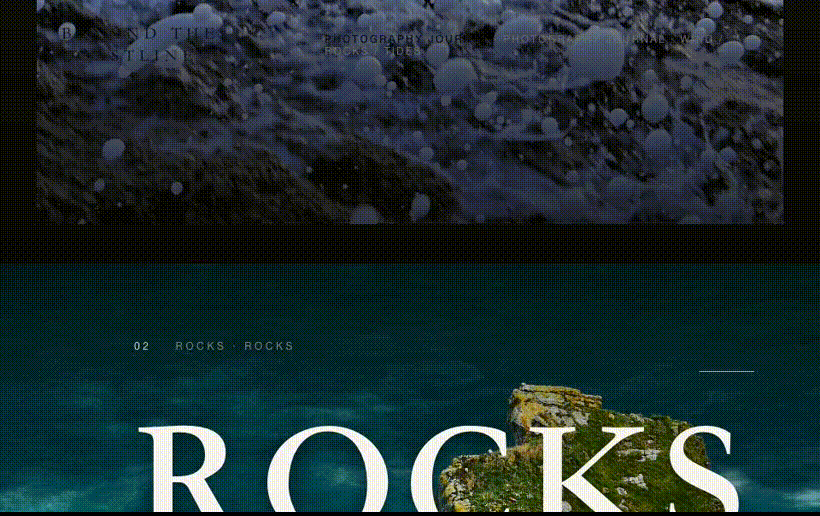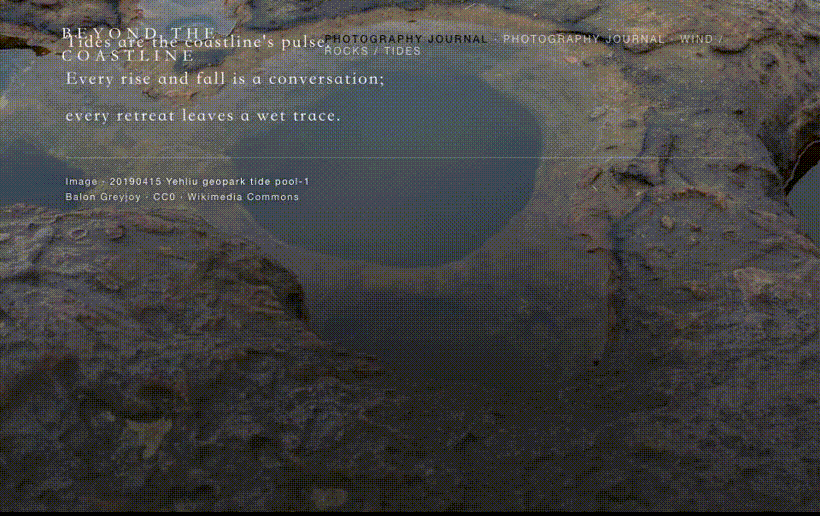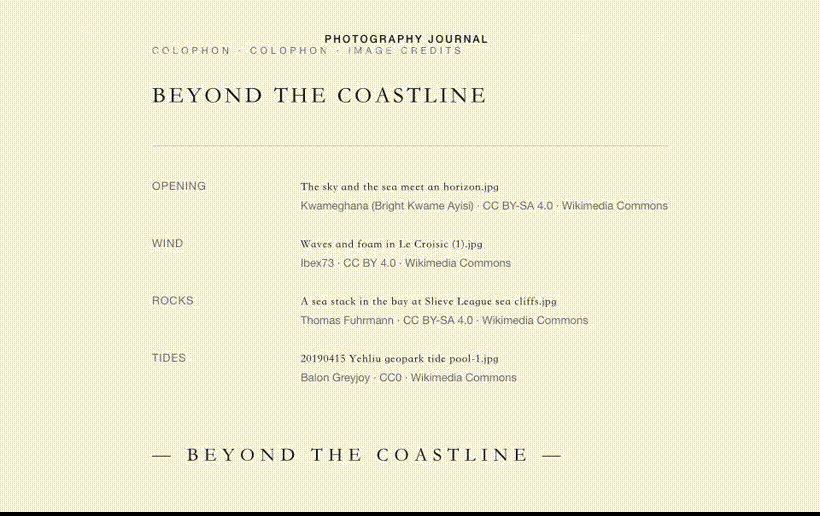
提示詞:製作《海岸線以外》攝影雜誌式HTML短篇網頁。採用米白與墨黑、巨大襯線字、簡潔中文說明及真正優質的海岸照片。開場海景嵌於字縫中,隨捲動展開至全螢幕,再連續進入風、礁石、潮汐三個章節;圖文之間須有精準留白與捲動節奏。參考 tympanus.net/Development/ImageExpansionTypography 的圖文展開關係。可使用合法公開圖片,儲存至本機並註明來源;不要以漸層色塊冒充攝影。
模型結構
SenseNova Loop-9B 以 32 層多模態解碼器為基礎,結合共享權重的循環運算、混合注意力及雙流流形約束超連接(mHC)。模型透過重用中間層參數擴展運算深度,支援文字與圖像輸入、文字輸出,以及最長 512K token 的上下文。
模型規格
項目 | SenseNova-Loop-9B |
架構 | 自回歸多模態解碼器;循環模組採用雙流 mHC |
參數規模 | 合共約 9B 參數,推理等效參數規模約 14.6B |
輸入 / 輸出 | 文字與圖像 / 文字 |
獨立解碼器層數 | 32 |
循環層範圍 / 執行次數 | [4, 28) / 2 次,共享權重 |
解碼器層執行次數 | 每次前向傳播執行 56 次 |
mHC 殘差流數量 | 2 |
上下文長度 | 512K tokens |
權重精度 | 主幹為 BF16;mHC 路由參數為 FP32 |
循環解碼器
輸入首先經過第 0–3 層,隨後依次通過同一組第 4–27 層兩次,最後由第 28–31 層及輸出頭生成模型輸出。若以 B 表示循環模組、h 表示其輸入,則循環運算可寫為 B(B(h))。
推理時,模型每次前向傳播完成 56 次解碼器層運算,僅需儲存 32 層解碼器權重。循環模組在兩次執行中重用同一組權重,第二次執行以第一次的輸出作為輸入。
混合注意力
解碼器交替使用線性注意力層與全注意力層。每四層為一組,依次包含三層線性注意力及一層全注意力。循環模組的邊界與完整的四層組對齊,因此兩次執行均保持相同的注意力排列。
雙流 mHC
在循環模組中,mHC 使用兩條殘差流傳遞解碼器層運算前後的資訊。可學習映射決定各層如何讀取殘差流、混合流間資訊,以及將層輸出寫入殘差狀態。流間混合映射採用 Sinkhorn 正規化進行約束;模型配置使用 20 次迭代。
可將兩條殘差流理解為並行傳遞的兩組隱藏狀態:每個循環層先從殘差流讀取資訊,執行注意力或前饋運算,再將結果寫回。流間混合矩陣透過反覆進行列、欄正規化,約束資訊在兩條流之間的混合;這 20 次正規化迭代屬於 mHC 內部運算,與循環模組執行兩遍是不同的步驟。
循環層範圍、執行次數及 mHC 路由參數共同構成模型檢查點的執行配置。相容的推理實作須載入這些參數,並保持相同的運算順序。
配置 | 數值 |
獨立解碼器層數 / 執行次數 | 32 / 56 |
循環層範圍 / 執行次數 | [4, 28) / 2 |
隱藏層維度 | 4,096 |
前饋網絡維度 | 12,288 |
詞彙表大小 | 248,320 |
全注意力頭數 / KV 頭數 | 16 / 4 |
mHC 殘差流數量 / Sinkhorn 迭代次數 | 2 / 20 |
Loop Scaling:探索循環運算的效益
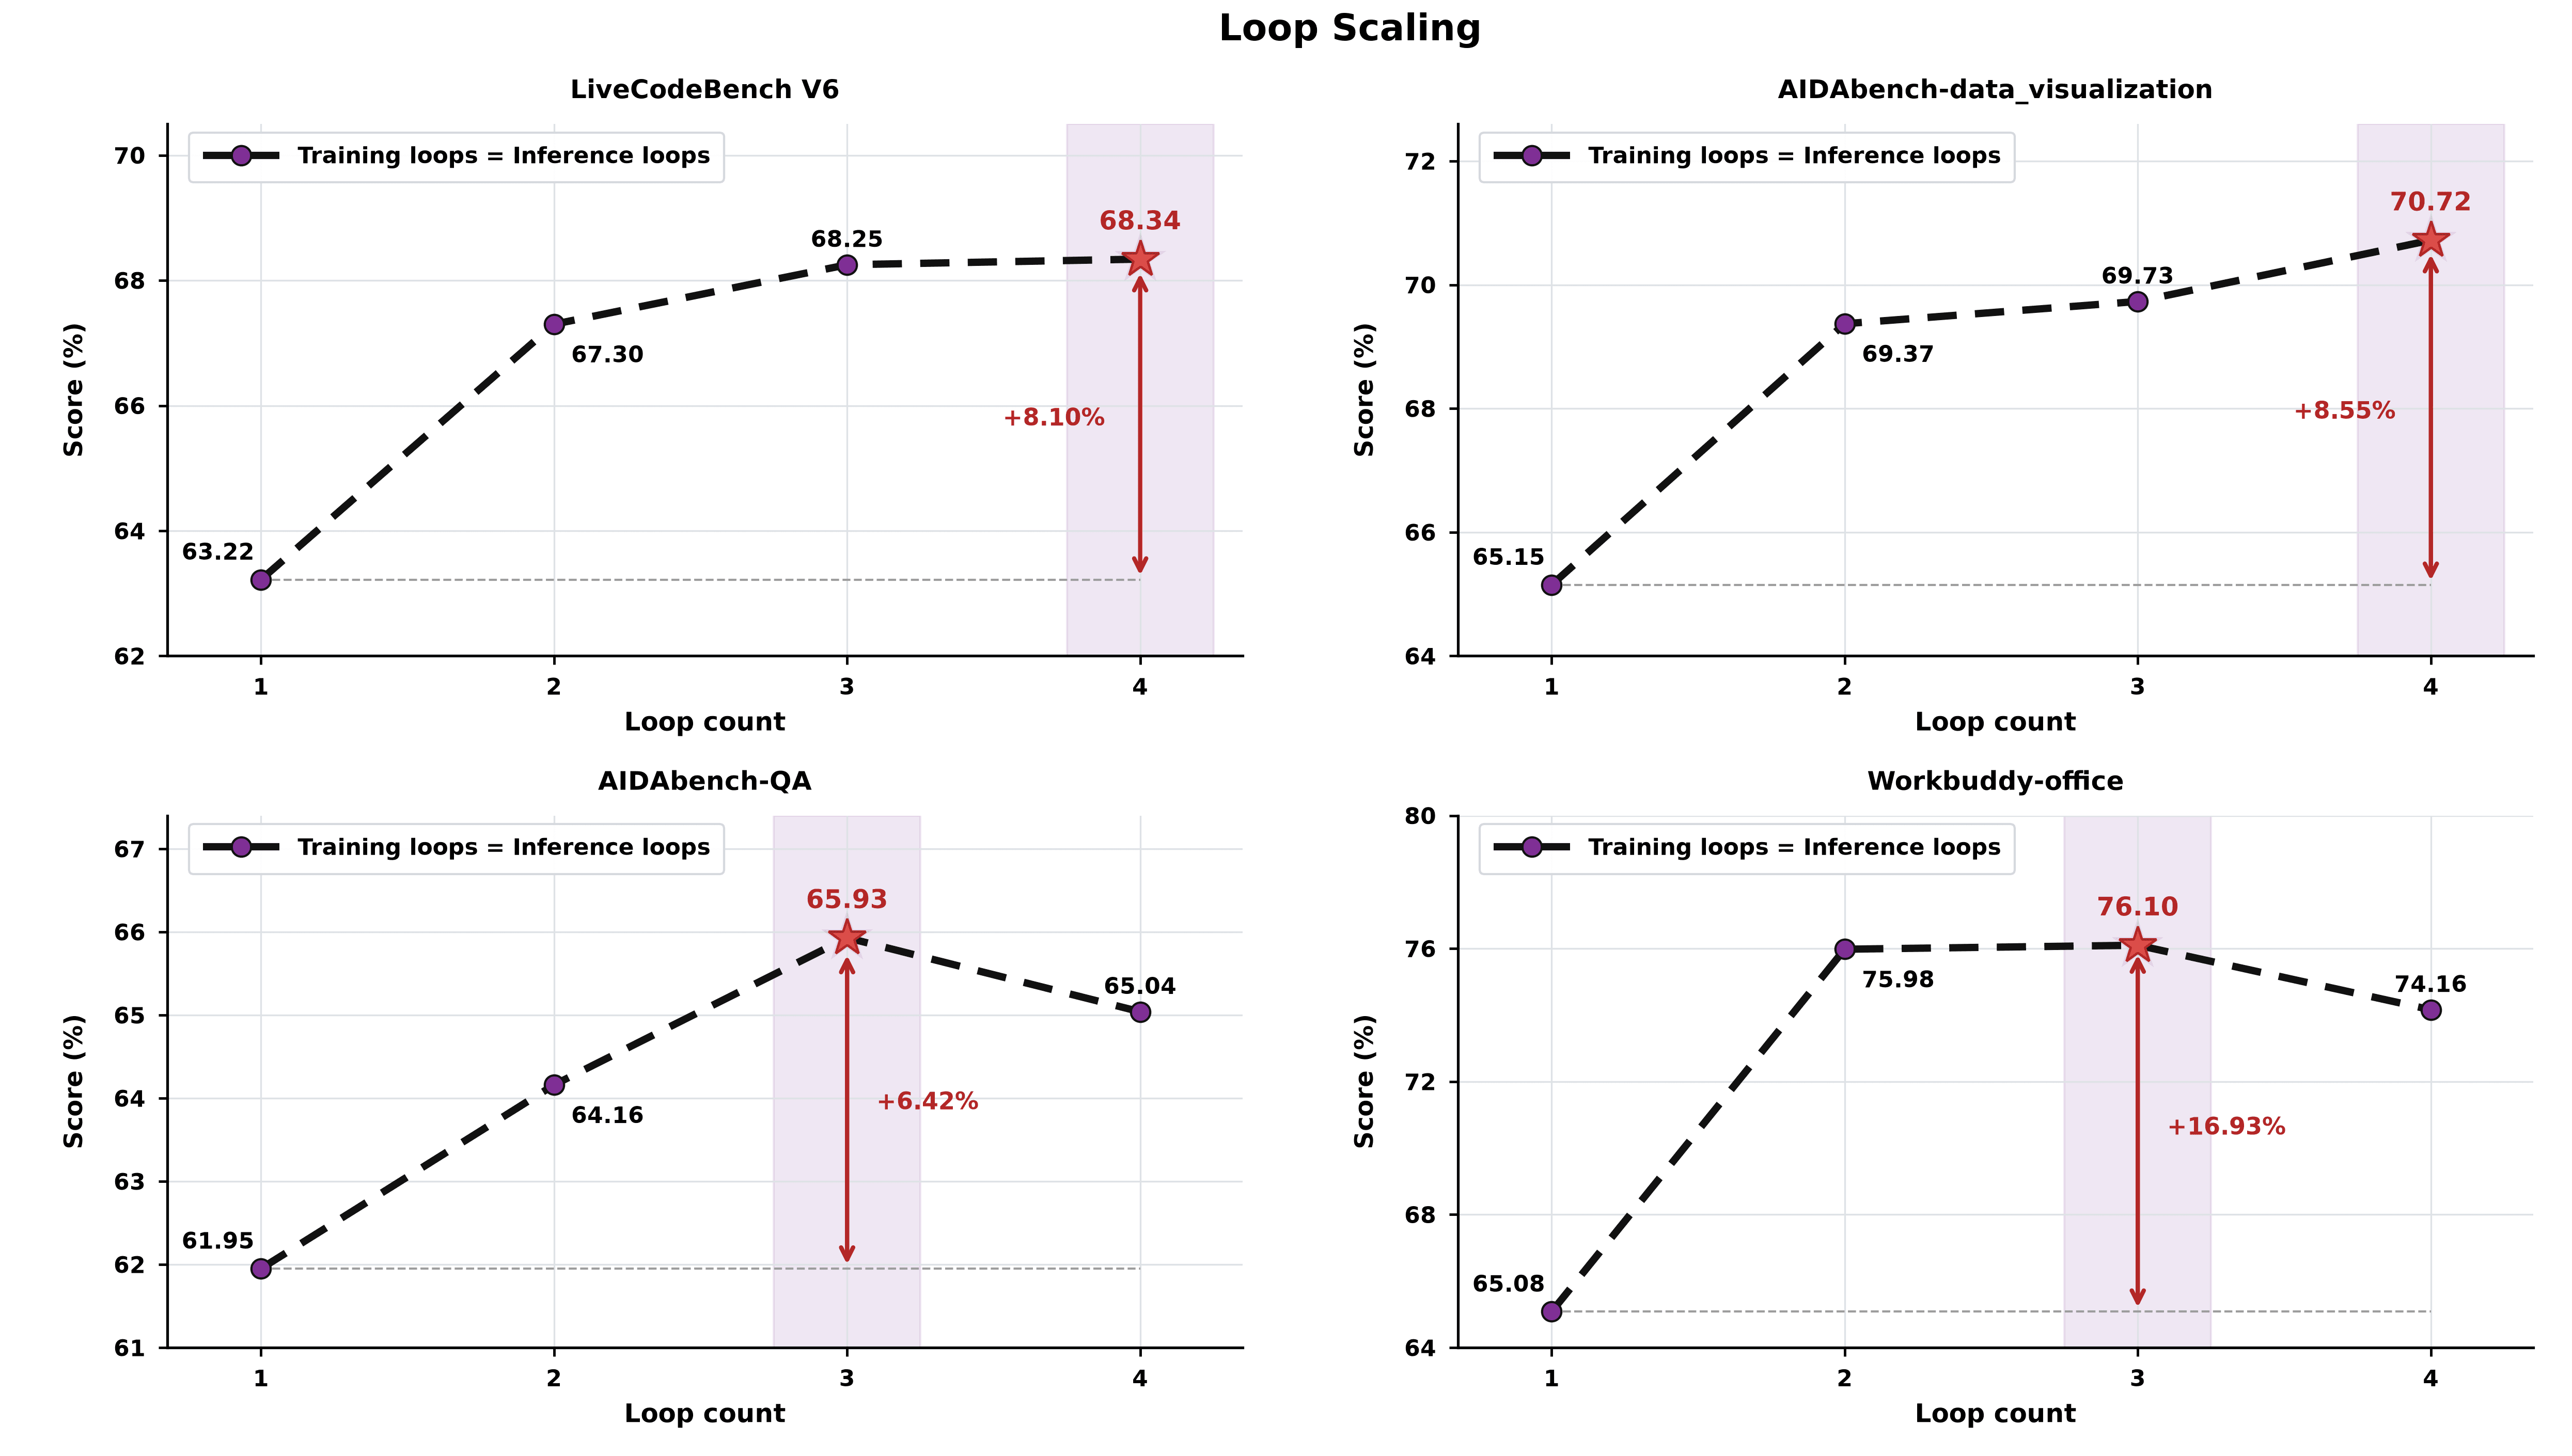
Looped Transformer 展現良好的效能擴展潛力,為模型能力提升提供循環運算這一新的探索維度。以原版 9B 模型(即圖中對應標準單次前向運算的 Loop 1)為基準,我們在保持訓練數據等配置一致的條件下,探索循環運算的擴展效果。實驗結果顯示,隨著訓練與推理的循環次數同步增加,模型在四項核心任務上的表現均呈上升趨勢。具體而言,AIDAbench-QA 及 Workbuddy-office 任務在 3 次循環時表現最佳,較 9B 基準分別提升 6.42% 及 16.93%;而在 LiveCodeBench V6 及 AIDAbench-data_visualization 任務中,4 次循環則進一步提升模型表現,分別實現 8.10% 及 8.55% 的效能增長。
綜合考慮實際應用的推理效率,我們目前的 Preview 及正式版模型均預設採用 2 次循環。然而,深層循環帶來的效能增益依然存在。以程式碼生成(LiveCodeBench V6)及數據視覺化(AIDAbench-data_visualization)兩項較複雜的任務為例,若將循環次數從目前的 2 次增加至 4 次,模型得分仍可分別提升 1.04 及 1.35 個百分點。這一結果印證 Loop Scaling 的有效性,亦表明目前 1 至 4 次循環的實驗僅是起點,更高循環深度蘊含的能力空間仍值得進一步探索。
此外,上述實驗結果亦清楚反映,不同類型任務對循環深度的需求存在顯著差異。基於這一觀察,在後續研究中,我們不僅會持續探索更高循環深度的能力邊界,亦將重點研究動態循環(Dynamic Loop)架構。該架構旨在讓模型根據輸入任務的複雜程度,自適應地匹配最佳循環次數,確保複雜任務獲得充足運算資源,同時兼顧整體推理效率。
適合顯示記憶體有限的硬件部署
受惠於 Loop 的循環共享結構,模型僅需約 9B 獨立參數,4bit 量化後的權重容量僅約 4.9GB,顯著降低本機及私有化部署的硬件門檻。結合 8 位元或 4 位元 KV 快取,可進一步降低長上下文推理所需的顯示記憶體。不同 KV 量化精度下,模型部署所需的最低顯示記憶體如下表所示:
上下文長度 | 8bit KV | 4bit KV |
64K | 約 10 GiB | 約 9 GiB |
128K | 約 12 GiB | 約 10 GiB |
256K | 約 15 GiB | 約 12 GiB |
現有限制與持續改進
儘管 Loop Transformer 架構已展現龐大潛力,但受限於模型規模及迭代時間,SenseNova Loop-9B 在以下方面仍有改進空間:
面對較多、較複雜的工具定義或多重條件約束時,模型仍可能出現理解與執行偏差,影響任務表現。
程式碼能力雖較 Preview 明顯提升,已具備良好的實用性,但在程式碼及通用智能體任務中的表現穩定性仍有不足;不過,模型可透過更多步驟修正自身錯誤。整體而言,處理複雜長程任務的能力仍須持續完善。
包含複雜 3D 場景及豐富動態元素的優質網頁,未必能在單輪互動中完成;部分案例須結合使用者意見,經過 2–3 輪修正才能達到理想效果。
我們將持續改善上述限制,並計劃未來將 Loop 架構應用於更大規模的模型,爭取以更頻密的模型更新回應實際使用需求,亦歡迎社群分享使用意見、問題案例及改進建議。
快速入門:使用SenseNova Loop-9B
模型權重及相關程式碼現已開放。開發者可透過 Hugging Face 模型儲存庫或本機模型目錄載入模型。
Hugging Face 儲存庫:https://huggingface.co/collections/sensenova/sensenova-loop
下方範例展示單張 GPU 上的文字生成,以及使用推理引擎啟動服務的方法。
環境要求
Preview 版本已驗證的環境為 Transformers 5.18.0、PyTorch 2.11.0 及 CUDA 13.0。模型目錄須包含配置、分詞器、對話範本、自訂模型程式碼及全部權重分片。
請先安裝與 CUDA 環境相容的 PyTorch,再安裝其餘相依套件:
bash |
使用 Transformers 生成文字
將 model_id 替換為正式版模型目錄或模型儲存庫 ID,然後執行以下程式碼:
python |
範例預設開啟思考模式,使用貪婪解碼,最多生成 512 個新 token。將 enable_thinking 設為 False 可關閉思考模式;修改 device 可指定使用的 GPU。trust_remote_code=True 用於載入 SenseNova-Loop 的自訂模型實作。
模型部署
以下指令參考 Preview 的部署範例,使用時請將模型路徑替換為正式版權重目錄;正式版對應的引擎版本及配置將隨發布更新。
LightLLM
以下為使用四張 GPU 進行部署的範例:
bash |
服務啟動後,可透過 OpenAI 相容介面發送請求:
bash |
SGLang
請使用包含 SenseNova Loop 實作的 SGLang PR #47281 對應版本,並替換模型路徑:
bash |
vLLM
請使用包含 SenseNova Loop 實作的 vLLM PR #64832 對應版本,並替換模型路徑。該 PR 目前僅支援未量化的文字推理,不適用於上文的 AWQ 4bit 低顯示記憶體配置:
bash |
模型權重及程式碼開源
GitHub:https://github.com/OpenSenseNova/SenseNova-Loop
Hugging Face:https://huggingface.co/collections/sensenova/sensenova-loop