SenseNova U1.5技術報告:邁向原生統一視覺智能
我們推出 SenseNova U1.5,一個採用 8B-MoT 架構的原生統一多模態模型,無需外部視覺編碼器和變分自編碼器(VAE),即可理解、推理和生成視覺內容。我們透過保持圖像區塊間空間連貫性的重建方式改進視覺介面,結合精選的生成與編輯數據、改進的任務建模、結構化提示增強及最高 4K 原生分辨率訓練,擴大訓練規模。後訓練階段,我們分別優化視覺美學、雙語文字渲染、信息圖生成和圖像編輯專家,再透過多專家同策略蒸餾整合其能力。
全面評測表明,SenseNova U1.5 在圖像保真度、文字渲染、複雜構圖、多參考圖編輯和交錯生成方面均取得顯著進展,同時提升指令遵循能力,保持主體身份特徵、幾何結構與非編輯區域的一致性。儘管生成訓練數據對結構化格式的覆蓋有限,模型仍能有效泛化至冗長而複雜的結構化視覺指令,進一步證明多模態理解能力能夠遷移至視覺規劃與創作。
這些結果表明,原生統一建模為構建集感知、推理與創作於一體的端到端系統提供了一條有前景的路徑。我們將開源包括監督微調、強化學習和同策略蒸餾在內的訓練代碼。代碼及更多模型信息:https://www.sensenova.cn/
SenseNova U1.5技術報告連結(歡迎社群關注):https://huggingface.co/papers/2609.11929
商湯小浣熊在線體驗:https://office.xiaohuanxiong.com/
Hugging Face 模型:https://huggingface.co/collections/sensenova/sensenova-u15
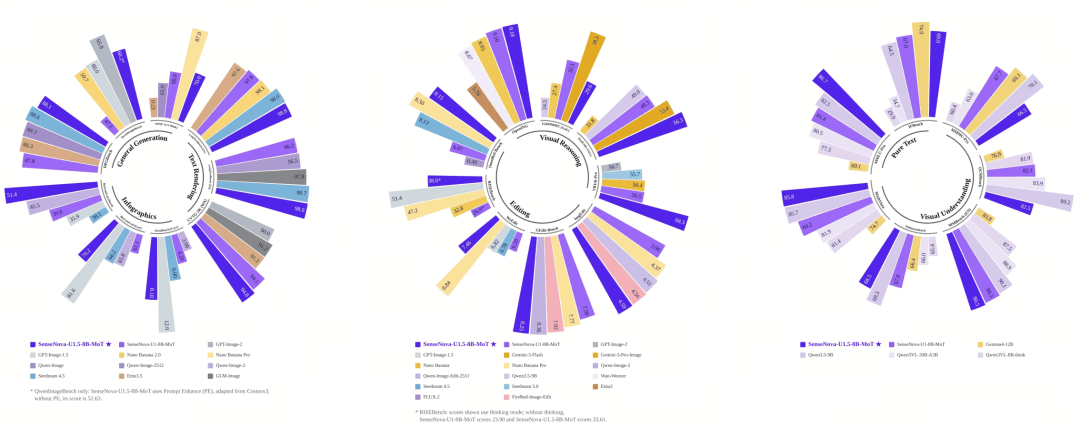
SenseNova U1.5 評測概覽
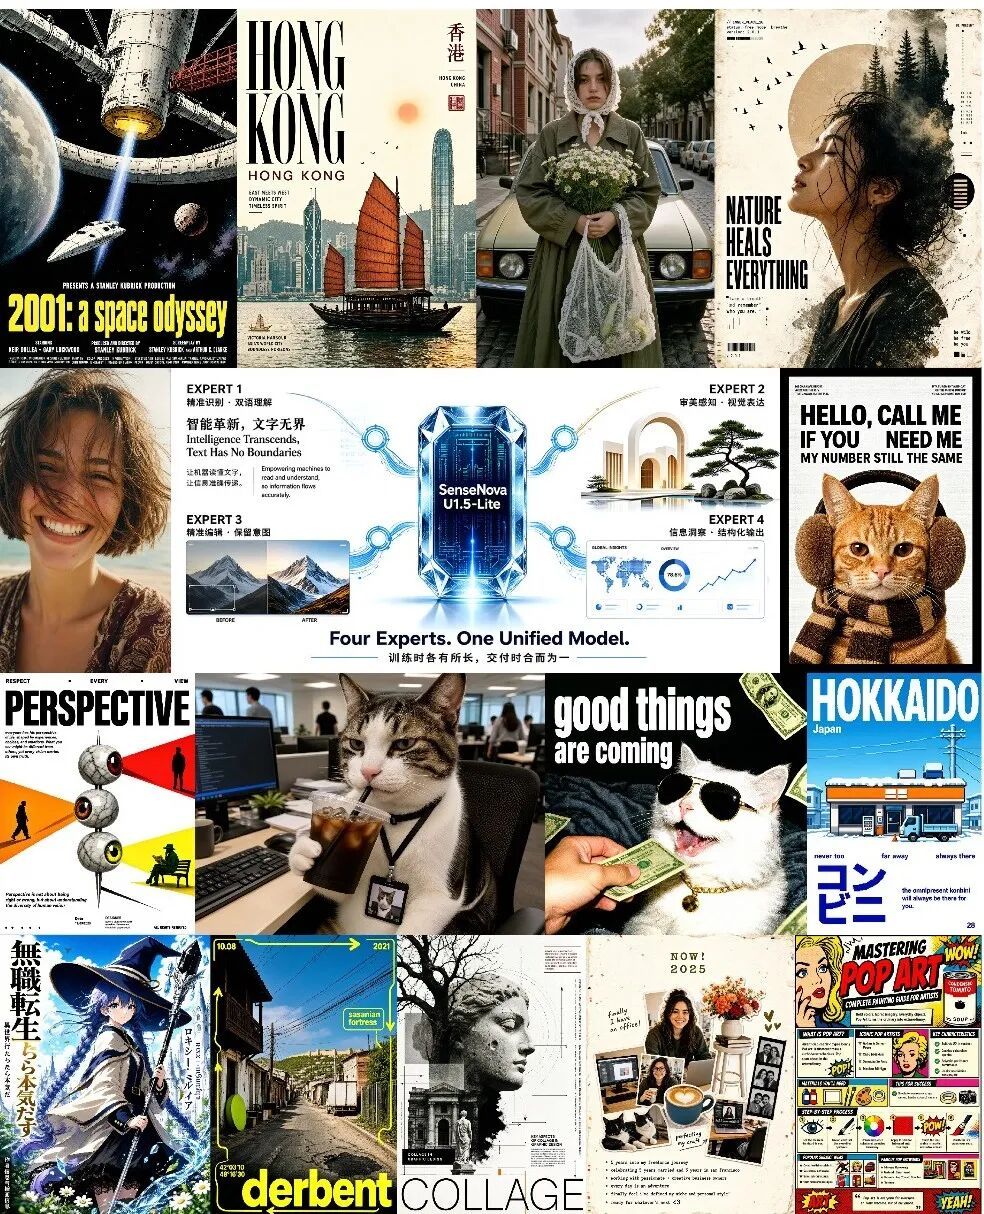
圖1 SenseNova U1.5 在信息圖與人物生成方面的示例。
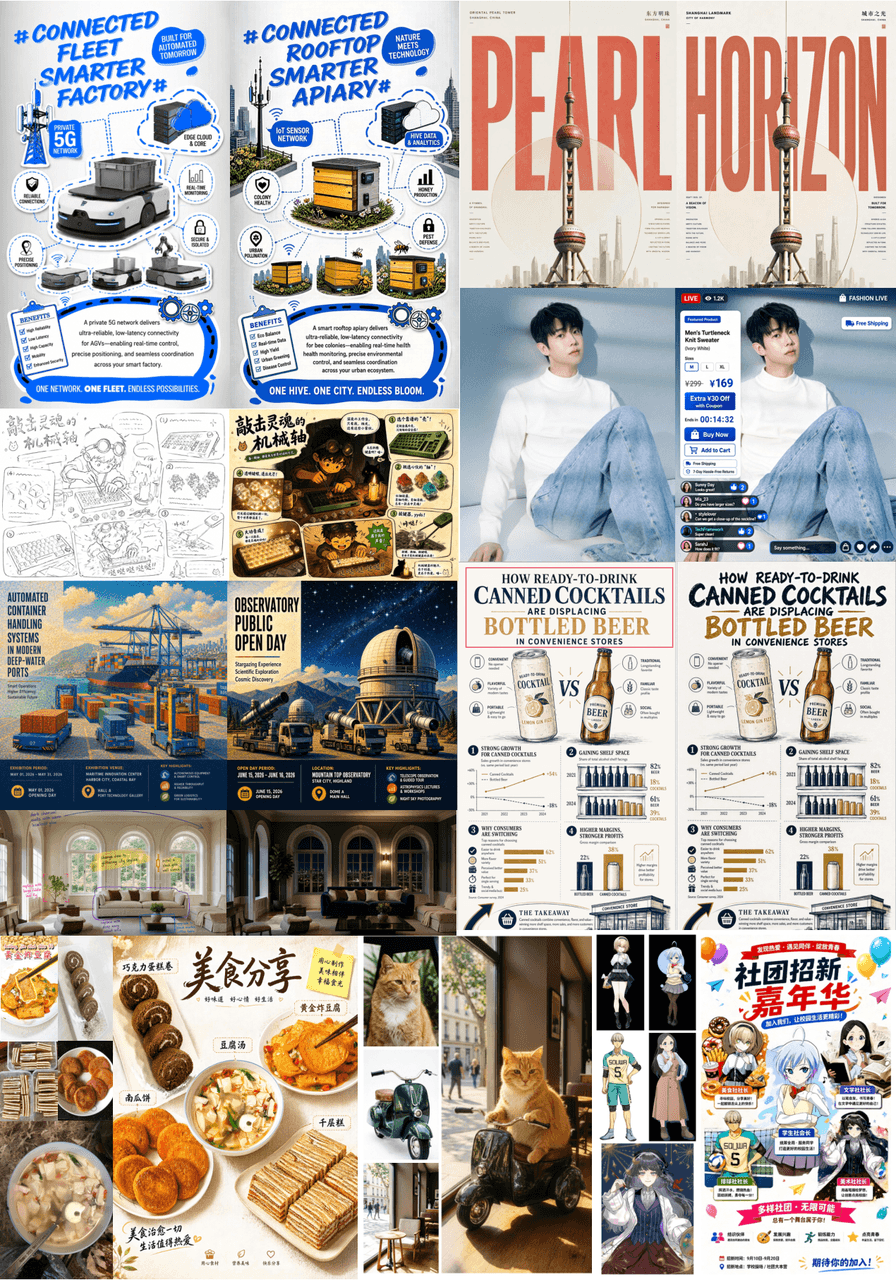
圖2 SenseNova U1.5 在圖像編輯與多參考圖生成方面的示例。
1 引言
近年來,視覺生成正迅速超越傳統的圖像合成,演化為一種通用的視覺創作媒介,涵蓋多語言文字排版、信息密集型設計、高分辨率渲染、多參考圖組合、細粒度物件與背景編輯,以及交錯生成。然而,這一範圍的拓展也暴露出架構層面的割裂:大多數系統透過預訓練視覺編碼器(vision encoders,VEs)感知圖像,卻透過變分自編碼器(VAEs)生成圖像。因此,理解與生成在不同的表示空間中運行:前者針對語義抽象進行優化,後者則針對像素級保真度進行優化。儘管這種分離方式是有效的,但它限制了感知、推理與生成在統一視覺框架中、面向多種視覺創作形式進行無縫協同的程度。
原生統一建模選擇了另一條路線,即直接從像素與文本中學習。SenseNova U1 透過不依賴外部編碼器和 VAE 的 NEO-unify 架構,驗證了這一範式的可行性,將感知、推理與像素空間生成納入同一個端到端模型。然而,其有意採用的輕量化視覺介面將每個視覺 token 重建為獨立的 RGB 圖像區塊。儘管這種方式效率較高,但這種因子化處理使圖像形成的最後階段無法在相鄰圖像區塊之間交換信息,導致接縫、紋理不連續和幾何不一致在高分辨率下愈發明顯。
本文提出 SenseNova U1.5,一個用於視覺理解、推理與生成的 8B-MoT 原生統一多模態模型。其核心首先在於一項重要的架構轉變:從獨立的圖像區塊預測轉向空間聯合重建。我們不再將各個視覺 token 彼此孤立地映射為像素,而是將 token 投影到二維特徵場中,並透過空間卷積和 Pixel Shuffle 上採樣逐步重建圖像。這使相鄰區域能夠在像素最終確定之前交換信息,從而聯合確定顏色、紋理與幾何結構,而非逐區塊獨立處理。由此形成的設計既保留了緊湊視覺序列的效率,又顯著改善了空間一致性,並支援最高達 4K 分辨率的原生生成。
第二項重要進展是從聯合獎勵優化轉向「先專精、再統一」的策略。視覺創作涵蓋本質上不同的能力,包括面向視覺美學的圖像生成、雙語文字渲染、信息圖設計和圖像編輯;每種能力都有不同的獎勵信號、採樣軌跡動態和優化難點。在單一策略中聯合優化這些能力,可能使相互競爭的目標糾纏在一起,稀釋任務特定的收益。因此,我們先進行專門化,再實現統一:針對不同能力,使用定制的數據、獎勵、採樣策略和正則化方法,分別優化專門的強化學習(reinforcement learning,RL)專家,隨後透過多專家同策略蒸餾整合它們的互補優勢。這一過程沿學生模型自身的生成軌跡實施蒸餾,在保留專家互補優勢的同時,將其能力遷移到一個統一策略中。
廣泛的評測進一步表明,單一的原生視覺表示能夠成為理解、推理、生成和編輯共享的基礎,無需並行的視覺處理路徑,也無需在編碼器特徵與 VAE 潛變量之間反覆轉換。儘管每個 32×3 像素區域都被壓縮為一個視覺 token,這種緊湊表示仍能支援高效推理,並在圖像保真度、雙語文字排版、複雜構圖、多參考圖編輯、交錯生成、指令遵循、視覺內容保持及細粒度控制等方面取得出色表現。更引人注目的是,儘管訓練對固定生成模板的依賴有限,SenseNova U1.5 仍能夠泛化至較長、具組合性且高度結構化的視覺指令。這表明,透過多模態理解與推理獲得的結構知識和規劃能力,能夠自然遷移至視覺創作中。總括而言,這些結果說明,原生統一不僅僅是架構層面的簡化:緊湊的共享視覺表示能夠高效支援「看」與「創作」,並使透過一種視覺智能形式學到的能力增強另一種能力。
2 相關工作
2.1 圖像生成數據原生統一多模態模型
原生視覺語言模型(vision-language models,VLMs)直接處理視覺輸入,不依賴外部編碼器。Fuyu-8B、EVE、Mono-InternVL、NEO、Gemma4-12B 和 Inkling 等模型已逐步縮小與領先模組化 VLM 的性能差距。視覺生成領域也出現了平行的發展趨勢:近期研究直接對像素進行建模,證明高保真合成不一定需要依賴高度壓縮的潛在空間。在這些進展的基礎上,原生統一多模態模型越來越多地嘗試在同一框架內融合理解與生成。其中,離散原生模型透過 token 級自回歸統一多模態學習,而連續原生方法則探索不依賴顯式分詞器或潛在瓶頸的端到端建模。基於 NEO-unify,我們的 SenseNova-U 系列進一步拓展了這一方向,邁向一個完全原生的基礎架構,使理解、推理和生成從共享的視覺基礎中湧現。
2.2 面向擴散模型的強化學習
在語言建模中,基於人類反饋的強化學習(reinforcement learning from human feedback,RLHF)建立了一種通用的後訓練範式:由學習所得的獎勵引導策略最佳化,並透過 PPO 相對於參考策略進行穩定更新。值得注意的是,GRPO 和 DAPO 透過移除顯式價值模型、引入組內相對優勢及改進的在線最佳化策略,提升了效率與可擴展性。在線強化學習也已擴展至視覺生成領域:ReFL、DDPO 和 DPOK 透過偏好獎勵或策略梯度最佳化擴散模型,而 AlignProp 和 D3PO 則提高了效率,並減少對顯式獎勵模型的依賴。近期,Flow-GRPO 與 DanceGRPO 將組內相對最佳化擴展至擴散模型和流匹配模型,改善了偏好對齊、組合準確性、文字渲染與視覺質量。
對於流匹配模型,在線強化學習需要在確定性的常微分方程(ordinary differential equation,ODE)推理之外引入隨機探索。Flow-GRPO 透過基於隨機微分方程(stochastic differential equation,SDE)的採樣軌跡實現這種探索;係數保持採樣(coefficients-preserving sampling,CPS)和 Precise 則透過更好地保留底層流動力學、平衡探索與分佈保真度,改善有限步採樣。除採樣之外,GRPO-Guard 透過受控裁剪和噪聲感知梯度重新加權,緩解獎勵過度最佳化。現有視覺強化學習還依賴特定能力的獎勵,包括評估感知質量和文圖對齊的偏好模型,以及針對文字排版和編輯的專用獎勵。受這些進展啟發,我們採用依任務而定的強化學習後訓練,將 CPS 或 Precise 採樣與交替使用的獎勵或任務特定獎勵相結合,以滿足生成和編輯不同的最佳化需求。
2.3 面向統一模型的同策略蒸餾
近期,同策略蒸餾(on-policy distillation,OPD)透過讓學生模型在自身生成的軌跡上接受教師模型的密集監督,緩解了傳統知識蒸餾中的分佈不匹配問題。在這一範式基礎上,MOPD 將 OPD 擴展至多教師能力整合:由獨立最佳化的領域專家監督學生模型的同策略採樣軌跡,從而將多種推理能力整合到單一模型中。在語言建模之外,OPD 也已被用於多模態理解與推理,由教師模型監督學生模型生成的多模態軌跡。其應用近期還擴展至視覺生成。具體而言,Flow-OPD、DiffusionOPD 和 DanceOPD 分別利用教師一致性訊號、轉移匹配和速度場回歸,沿學生模型生成的去噪軌跡蒸餾任務專門化生成器。此外,DiffusionOPSD 則移除了外部教師模型,利用可微獎勵梯度構造有界的自蒸餾目標。我們的設置與這些方法形成互補:我們不強行讓所有任務採用同一套蒸餾方案,而是保留四個任務專門化的外部專家,透過硬路由將其監督訊號送入同一個原生像素空間模型。這一設計在整合專門化能力的同時,保留了各專家依任務而定的條件輸入、引導方式和分辨率策略。
3 方法
3.1 模型架構
近乎無損的視覺介面。 SenseNova U1.5 保留了 NEO 提出的輕量級原生視覺介面,將原始圖像或加入噪聲的視覺輸入直接變換為緊湊的 token 序列,無需外部視覺編碼器或 VAE。具體而言,兩個帶有 GELU 激活的卷積投影分別執行 16 倍和 2 倍下採樣,使每個 32 × 32 圖像區域對應一個視覺 token。二維正弦位置嵌入保留空間座標,而特殊 token 則用於界定各個視覺區塊。文本使用原始語言分詞器進行分詞,隨後將視覺與文本表示投影到共享隱藏空間,由統一主幹網絡聯合處理。這種設計在保留近乎無損視覺信息的同時,使序列長度保持在大規模多模態建模可處理的範圍內。
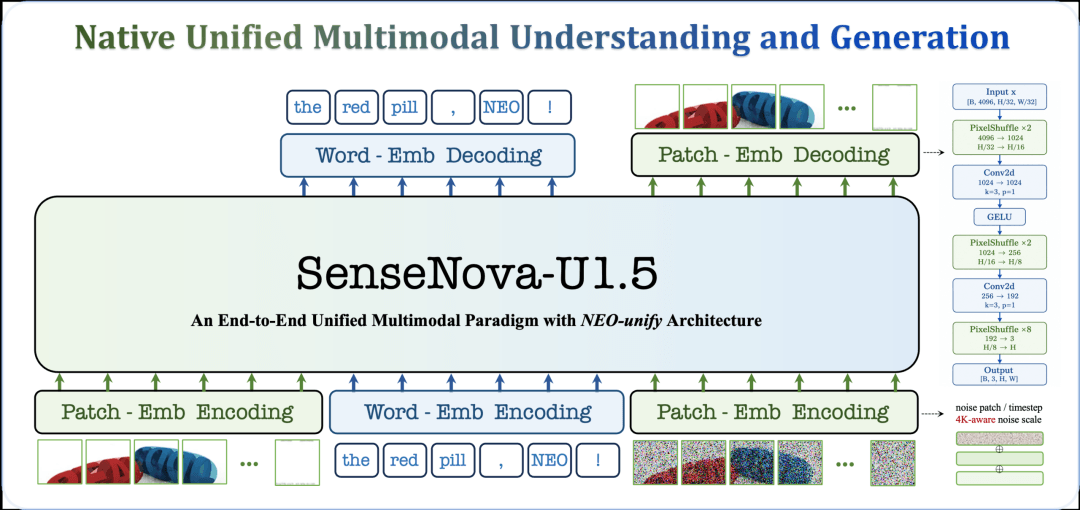
圖 3 SenseNova U1.5 概覽。與 SenseNova U1 相比,U1.5 在編碼和解碼兩端進一步改進了近乎無損的視覺介面:分辨率感知噪聲條件擴展至 4096 × 4096 範圍,原始逐圖像區塊 MLP 輸出頭被採用 Pixel Shuffle 與 3 × 3 卷積的輕量級空間解碼器取代。這些改進保留了每個 32 × 32 像素區域對應一個視覺 token 的緊湊表示方式,同時增強空間連續性、高分辨率保真度和下游穩健性。
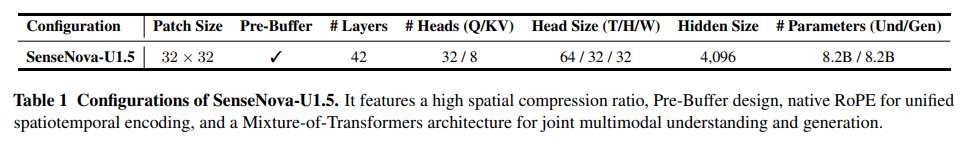
表 1 SenseNova U1.5 的配置。模型採用較高的空間壓縮比、Pre-Buffer 設計、用於統一時空編碼的原生 RoPE,以及聯合進行多模態理解與生成的 Mixture-of-Transformers 架構。
對於生成任務,有效噪聲幅度會隨圖像分辨率變化,因此,分辨率也是去噪過程的重要條件。SenseNova U1.5 顯式引入依賴分辨率的噪聲尺度嵌入,並將參考圖分辨率從 2048 X 2048 擴展至 4096 X 4096,以更好地支援原生高分辨率生成。模型對相應的噪聲尺度進行歸一化和編碼,再與擴散時間步表示融合,使去噪器同時感知當前去噪階段和與分辨率相關的噪聲特徵,從而更穩定地適應不同分辨率與寬高比。
緊湊的圖像區塊劃分降低了圖像建模成本,但透過 MLP 獨立解碼每個圖像區塊,容易破壞局部連續性,在高分辨率下產生接縫、網格偽影及紋理不連續。為此,SenseNova U1.5 以輕量級空間耦合解碼器取代原有的 MLP 輸出頭。如圖 3 所示,解碼器首先將主幹網絡輸出的視覺 token 還原為二維特徵圖,再透過三級 Pixel Shuffle 上採樣,逐步重建全分辨率 RGB 圖像。各級之間的局部卷積讓相鄰區域能夠交換信息,共同確定圖像區塊邊界附近的像素,而非逐個區塊獨立預測。
該解碼器在像素合成前恢復局部空間互動,讓全局語義、構圖及細粒度結構能夠在同一個端到端框架內聯合優化。它與主幹網絡在流匹配目標下共同訓練,僅增加少量計算開銷,便能改善跨圖像區塊的一致性及局部連續性,減少邊界偽影,並提升高分辨率生成及下游適配的穩定性。
原生 Mixture-of-Transformers。 SenseNova U1.5 保留原生 Mixture-of-Transformers(MoT)設計,在同一個 Transformer 主幹網絡中整合理解與生成,而非將兩者完全拆分為兩個獨立網絡。乾淨的圖文上下文與噪聲條件化視覺狀態在統一序列中交錯排列,讓語義表示、視覺證據及生成動態能夠透過共享自注意力直接互動。這種設計讓生成過程能夠持續利用多模態理解過程中形成的表示,無需引入輔助融合模組或跨空間特徵轉換。
注意力模式經過結構化設計,以協調因果語言建模與雙向視覺互動。文本 token 僅關注此前的上下文;每個乾淨圖像區塊內的 token 則進行雙向注意,以捕捉空間依賴。噪聲條件化的生成 token 同樣在其圖像區塊內進行雙向互動,並關注此前全部乾淨的多模態上下文。反向路徑會被明確遮蔽,防止乾淨表示存取隨機生成狀態。這種非對稱信息流讓生成過程能夠利用豐富的語義及視覺上下文,同時保持用於理解與推理的表示的完整性。
關鍵在於,架構統一並不代表所有位置都共享參數。理解與生成保留獨立的注意力投影、正規化層及前饋模組,並在每一層 Transformer 中按 token 類型進行動態路由。因此,共享注意力充當跨流通訊的介面,而流專用參數則保留感知與合成所需的不同計算。這種密集互動與參數專門化的結合,讓兩種能力都能受益於共同的表示空間,而不必將各自不同的優化目標強行納入同一條計算路徑。
統一訓練目標。 SenseNova U1.5 將自回歸語言建模、像素空間流匹配及感知監督結合,在同一個模型中聯合訓練理解與生成能力。
對於多模態理解,模型根據現有的圖文上下文及此前的文本,依次預測後續文本 token,透過提高正確預測的概率,學習語義理解及多模態推理。
對於視覺生成,模型直接在 RGB 像素空間中學習從噪聲到圖像的連續轉換。訓練時,將真實圖像與按目標分辨率調整幅度的高斯噪聲混合,構造不同生成階段的帶噪狀態。模型從這些狀態預測乾淨圖像,並據此估計生成軌跡的變化速度,再透過流匹配損失縮小預測速度與目標速度之間的差異。
在此基礎上,模型引入 LPIPS 感知損失,在特徵空間中比較預測圖像與真實圖像,進一步約束結構一致性、局部紋理及視覺連貫性,補充像素空間的監督信號。三類損失按權重組合並聯合優化,讓語義理解、圖像生成及視覺質量約束相互配合,使高層語義與底層視覺生成在統一表示中共同學習。
3.2 訓練流程
SenseNova U1.5 逐步構建原生多模態能力,依次經歷生成預訓練、統一中期訓練及統一監督微調(階段 1—3),具體設定見表 2。其後,再進行能力特定學習(階段 4)及多專家同策略蒸餾(階段 5)。
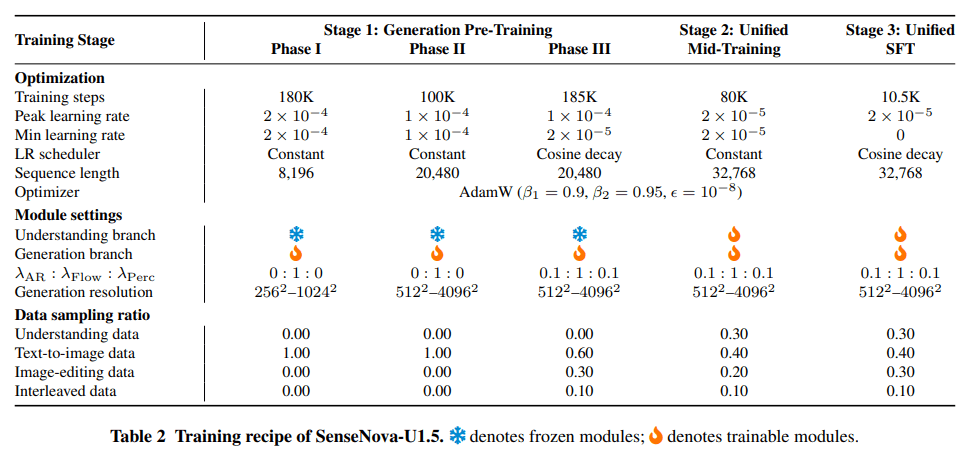
表 2 SenseNova U1.5 的訓練方案。
階段 1:生成預訓練。 在預訓練理解分支的基礎上,我們隨機初始化生成分支,並以凍結的理解分支提供的表示作為條件,透過像素空間流匹配訓練生成分支。SenseNova U1.5 增加了計算預算,並引入專門的原生 4K 訓練階段。訓練首先使用分辨率由 256×256 至 1024×1024 的文生圖數據。在這一階段,我們以 2×10⁻⁴的固定學習率訓練 180K 步,序列長度為 8,196。其後,將文生圖數據擴展至 512×512 至 4096×4096 的更高分辨率,以增強模型的原生 4K 生成能力。這一階段以 1×10⁻⁴的固定學習率訓練 100K 步,並將序列長度增加至 20,480。在最後一個階段,我們引入圖像編輯及交錯生成任務,繼續訓練 185K 步,將模型的生成能力拓展至多種下游場景。訓練混合數據中,60% 為文生圖數據,30% 為圖像編輯數據,10% 為交錯圖文數據。我們採用餘弦學習率調度,將學習率由 1×10⁻⁴衰減至 2×10⁻⁵,序列長度維持為 20,480。由這一階段開始,我們在流匹配目標之外增加基於 LPIPS 的感知損失,其權重為 0.1,以改善細粒度視覺細節的生成及局部視覺連貫性。值得注意的是,這一組合生成目標在其後的統一中期訓練及監督微調階段中保持不變。
階段 2:統一中期訓練。 我們聯合優化兩個分支,共享注意力促進跨分支信息交換,同時保留任務專用表示。為平衡通用多模態能力與多樣化生成能力,我們構建混合語料,其中 30% 為純文本及多模態理解數據,40% 為文生圖數據,20% 為圖像編輯數據,10% 為交錯圖文數據。這種混合讓模型能夠在統一訓練階段接觸感知、合成、編輯及多模態互動等互補形式。模型訓練 80K 步,最大序列長度為 32,768 個 token,固定學習率為 2×10⁻⁵ 。理解損失及生成損失的權重分別為 0.1 及 1.0。這一權重設定有助於保留預訓練理解能力,同時將更大的優化權重賦予更具挑戰性的生成目標,從而實現穩定的聯合訓練及更有效的能力整合。
階段 3:統一監督微調。 我們進一步使用精心篩選的高質量指令遵循數據對模型進行微調,任務構成與階段 2 相近。這一階段進一步增強指令遵循能力,並將早期訓練獲得的能力鞏固到統一模型中。訓練進行 10.5K 步,採用餘弦學習率調度,將學習率由 2×10⁻⁵衰減至 0,同時保留與階段 2 相同的損失係數,以維持理解目標與生成目標之間的平衡。
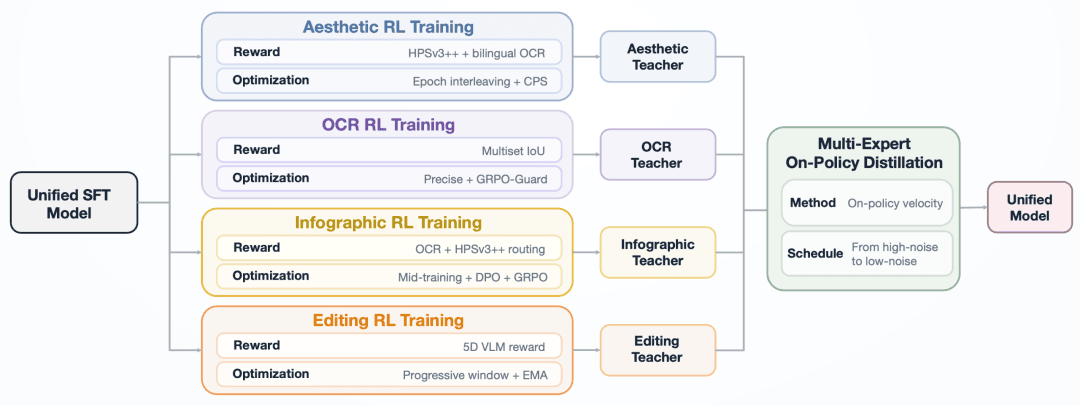
圖 4 SenseNova U1.5 的後訓練流程,包括多專家強化學習與同策略蒸餾。
階段 4:多專家強化學習。如圖 4 所示,我們分別訓練美學、文字渲染、信息圖表生成和圖像編輯四個專家,每個專家採用任務特定的資料、獎勵、取樣與正則化設定。
(1)美學專家。僅優化視覺偏好可能會改善整體外觀,卻犧牲文字可讀性。因此,我們在不同訓練週期(epoch)之間交替使用美學偏好資料與文字排版資料來訓練美學專家。各資料分區的樣本會被路由至任務特定的獎勵:HPSv3++ 評估感知質量及提示與圖像的對齊程度,基於 PaddleOCR 的雙語 OCR 獎勵則衡量文字保真度。這種路由避免將尺度與語義不同的獎勵混合在一起,同時在偏好優化過程中保留文字排版準確性。
對於每條提示,我們使用 30 步軌跡生成 16 個候選結果,引導尺度為 4.0,時間步偏移為 3。我們採用 η = 0.7 的係數保持取樣(CPS),在引入隨機探索的同時,減少傳統 SDE 取樣帶來的有限步偽影。
每次更新時,我們從軌跡的前 10 步中均勻取樣一個連續 5 步的窗口,將優化集中在主要決定全局內容與構圖的早期去噪階段。訓練採用動態分辨率和寬高比,恒定學習率為 2×10⁻⁵,參考策略 KL 係數為 0.01。為減少獎勵引發的漂移,我們在強化學習過程中凍結生成分支最後一個 Transformer 區塊、流匹配輸出頭及其輸出正規化層。
(2)OCR 專家。OCR 專家專門提升模型準確渲染雙語文字的能力。對每條提示,我們提取預期出現在圖像中的文字作為目標,並使用 PaddleOCR 識別生成內容。隨後,在識別文字與目標文字之間計算歸一化多重集交並比:英文按單詞匹配,中文按字符匹配。與完全匹配相比,這種分級獎勵能夠更好地反映部分正確的生成結果,同時仍對遺漏、重複和渲染錯誤保持敏感。
我們為每條提示生成 16 個候選結果,採用 30 步軌跡,引導尺度為 4.0,時間步偏移為 3,並從前 10 步中取樣一個連續 5 步的優化窗口。軌跡取樣採用係數為 1.5 的 Precise 取樣,同時使用 GRPO-Guard 在高 OCR 獎勵稀疏的情況下穩定優化。訓練採用動態分辨率和寬高比,恒定學習率為 2×10⁻⁵,參考策略 KL 係數為 0.02。我們同樣在強化學習期間凍結生成分支最後一個 Transformer 區塊、流匹配輸出頭及輸出正規化層。
(3)編輯專家。有效的圖像編輯需要平衡三個目標:指令遵循、未編輯內容的保留,以及編輯區域的視覺質量。編輯不足可能導致指令僅被部分執行,過度編輯則可能改變應保持不變的內容。因此,編輯專家必須學習應修改甚麼、應保留甚麼,以及如何將所要求的改動自然地融入源圖像。
編輯專家採用 4×10⁻⁵ 的恒定學習率、0.01 的 KL 係數、24 的軌跡取樣組大小,以及 0.7 的噪聲尺度,並使用指數移動平均(exponential moving average,EMA)。我們避免基於 SDE 的軌跡取樣,因為過強的隨機擾動可能引入殘餘噪聲和視覺偽影。在這一設定下,我們進一步引入兩項編輯專用策略,以提供有針對性的獎勵監督,並提高優化效果。
(i)多維獎勵。我們使用基於 VLM 的獎勵框架,從五個維度評估編輯質量:指令完成度、編輯執行、整體視覺質量、適用情況下的文字編輯質量,以及未編輯區域的保留情況。這些互補信號針對不同失效模式提供定向監督,同時平衡編輯準確性、視覺保真度和內容保留。
(ii)漸進式訓練。我們採用漸進式滑動窗口策略,將優化重點從建立語義的早期階段,逐步移動到細化紋理的後期階段。這種由粗到細的推進方式先確保預期結構變化,再改善局部保真度及其與周圍內容的視覺融合。
(4)信息圖表專家。信息圖表生成需要準確的文字渲染、連貫的密集布局、清晰的信息層級和較高的整體視覺質量。信息圖表專家首先經歷從面向信息圖表的中期訓練到任務特定強化學習的完整訓練流程,旨在更顯著地改善小字號文字渲染及相關能力。在中期訓練中,我們引入高質量真實資料和合成資料,並重新平衡信息圖表子類別之間的分佈,以及信息圖表資料與其他類別資料的混合比例。這進一步改善了小字號文字渲染、複雜布局處理、信息組織和整體視覺設計質量。
隨後,我們通過三個階段進一步優化信息圖表專家。第一階段採用與 OCR 專家相同的訓練資料和文字保真度獎勵,改善文字渲染。第二階段對精心篩選的偏好對應用直接偏好優化(direct preference optimization,DPO),以提高整體視覺質量;恒定學習率為 5×10⁻⁶ ,DPO 損失係數為 10,每次更新從第 1—20 步中取樣一個時間步。最後一個階段交替使用文字渲染資料和美學資料,分別將其路由到文字保真度獎勵與 HPSv3++,而不是合併兩個分數。
第一階段和最後階段均採用組相對策略優化(group relative policy optimization,GRPO),使用係數保持取樣(CPS),在 30 步軌跡上為每條提示生成 16 個候選結果。無分類器引導僅在為獎勵評估收集取樣軌跡時使用,而策略目標僅由條件預測計算。兩個階段的恒定學習率均為 2×10⁻⁵ ,參考策略 KL 係數均為 0.01。
階段 5:多專家同策略蒸餾。如圖 4 所示,我們採用同策略速度場蒸餾,將美學、文字渲染、信息圖表生成和圖像編輯四個專家的能力整合到單一統一模型中。每個訓練樣本根據所屬能力類別,被分配給對應的凍結專家。學生模型先根據文字或圖文條件生成自己的去噪軌跡,再由學生與專家在相同的中間狀態、時間步和輸入條件下分別預測生成過程的變化速度。訓練通過最小化兩者速度預測的平方誤差,將專家能力傳遞給學生。
在這一過程中,所取樣的中間狀態被視為固定輸入,梯度不會沿完整取樣軌跡反向傳播。每個訓練週期只使用一種能力的資料及其對應專家,並按固定順序輪換。
文生圖和圖像編輯均採用固定 30 步的確定性常微分方程(ODE)去噪,每條軌跡只選取一個時間步查詢專家。查詢位置按照隨訓練輪次變化的 Beta 分佈進行抽樣:訓練初期更關注軌跡前段的高噪聲狀態,以學習全局結構;其後逐步轉向後段的低噪聲狀態,強化細節與文字保真度。為保持訓練和推理一致,我們直接優化無分類器引導(CFG)下的速度預測。美學、OCR 和信息圖專家的引導尺度為 4,並使用全局範數裁剪;編輯專家的引導尺度為 1。
對於文生圖,我們首先從 10242,15362,20482,30722,40962中選擇目標面積,並從 1:1,16:9,9:16,4:3,3:4,3:2,2:3,1:2,2:1 中選擇目標寬高比。在保持目標面積的前提下計算寬高,並將尺寸取整至最接近的 32 像素倍數。圖像編輯則沿用源圖像分辨率,僅進行相同的尺寸取整。
學生模型共訓練 800 個優化器步數,全局批次大小為 128,梯度累積次數為 1,每個領域使用 25,600 個樣本。訓練採用 AdamW 優化器,學習率為,一階和二階矩估計的衰減係數分別為 0.9 和 0.999,權重衰減為 2×10⁻⁵,最大梯度範數為 1,並使用 BF16 混合精度。理解分支、生成分支最後三層及生成輸出頭保持凍結。採樣按照 30 步軌跡設置進行,但在完成選定的查詢轉移後立即終止,避免計算其後不會使用的軌跡。
3.3 獎勵建模
美學獎勵。美學質量綜合反映構圖、視覺保真度、語義一致性、風格連貫性和人類偏好,難以通過人工設計的單一目標充分刻畫。因此,我們使用 HPSv3++ 提供偏好獎勵。其訓練方式同時考慮模型能力差異和迭代過程,適用於生成質量持續提高、輸出分佈不斷變化的強化學習後訓練。相比基於固定生成分佈訓練的評分器,它能夠提供更穩健、更具適應性的偏好監督,幫助模型改善感知質量,減少對狹窄獎勵目標的過擬合。
OCR 獎勵。僅依賴偏好獎勵不足以保證文字正確,因為視覺上合理的圖像仍可能存在文字缺失、重複或字形錯誤。我們因此引入顯式 OCR 獎勵:從提示中提取目標文字,使用 PaddleOCR 識別生成圖像,並對大小寫、標點和空白進行正規化處理。英文按詞切分,中文按字元切分。
評分採用多重集交並比。對於每個詞或字元,分別統計其在目標文本和識別文本中的出現次數,將較小次數計入匹配量、較大次數計入總量,再以匯總後的匹配量佔總量的比例作為獎勵。這種方式獎勵正確出現的文字,同時懲罰遺漏、額外生成和重複錯誤,也能更穩健地應對密集或多區域佈局中不可靠的 OCR 閱讀順序。
在後訓練中,美學提示與 OCR 提示分別使用各自的獎勵,並在訓練輪次之間交替使用,避免在單個樣本中混合尺度不同的獎勵。
信息圖獎勵。我們沒有引入額外的信息圖專用獎勵模型,而是根據訓練階段與任務類型,重用 OCR 獎勵和美學獎勵。第一個訓練階段僅使用 OCR 獎勵進行預熱,優先提高文字保真度;最後一個訓練階段則按提示所屬類別分配獎勵:文字渲染提示使用 OCR 獎勵,美學提示使用 HPSv3++。
兩類分數不相加,也不相互歸一化。這種任務路由保留了各自的尺度與語義,同時為文字準確性和感知質量提供互補監督。
編輯獎勵。圖像編輯的獎勵不僅需要判斷所要求的改動是否完成,還要評估結果是否在視覺上可信,以及與編輯無關的源內容是否得到保留。單一整體評分可能掩蓋不同類型的錯誤,讓某一方面的優勢抵消另一關鍵方面的失誤。因此,我們採用多個維度分別評估編輯質量。
其中,指令完成度衡量編輯結果的語義正確性及所要求改動的完整程度;編輯執行質量評估目標區域的視覺質量及其與周圍內容的自然融合程度;整體視覺質量考察全局技術質量和預期風格的一致性;文字編輯質量在涉及文字修改時,評估文字正確性與渲染質量;未編輯區域保留則比較源圖像與編輯結果,懲罰目標區域之外非預期的語義、結構或視覺變化。
對於包含多個子維度的評估項,我們保留其中的最低分。各項評分歸一化後,最終獎勵取所有適用維度中的最低值,而不是平均值。不涉及文字修改時,不納入文字編輯評分;當圖像中看不到任何所要求的變化時,編輯執行分數設為 0。
這種以最弱項決定整體獎勵的方式,避免某個維度的高分掩蓋其他維度的關鍵錯誤,使獎勵始終對編輯不完整、非預期修改和局部質量缺陷保持敏感,為圖像編輯強化學習提供更均衡、更可靠的監督。
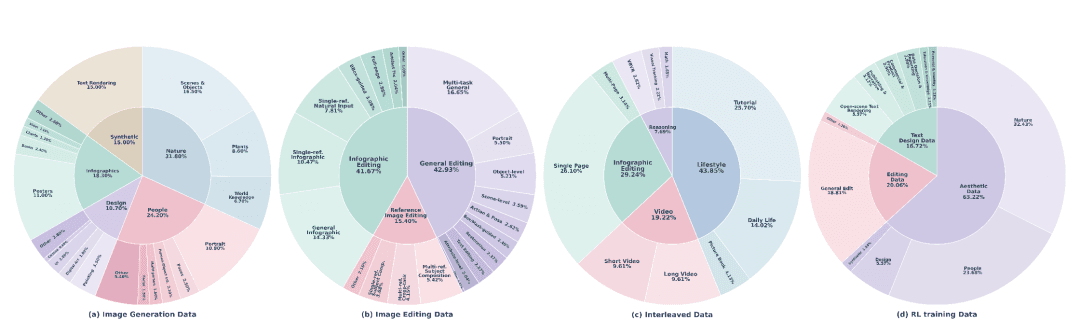
圖 5 SenseNova U1.5 的訓練語料。從左至右,圖表依次展示圖像生成、圖像編輯、交錯生成和強化學習訓練數據集的層級構成。內環表示主要數據類別及其比例,外環進一步分解為細粒度子類別。
4 數據構建
如圖 5 所示,SenseNova U1.5 在 SenseNova U1 的基礎上大幅擴展了訓練語料,重點增強數據多樣性、視覺質量、高分辨率生成、複雜指令遵循與細粒度圖像編輯能力。除擴大數據規模外,我們還通過質量感知篩選、分佈再平衡、更強的圖文對齊,以及針對覆蓋不足能力的定向合成,系統性地改進數據篩選與整理。
4.1 圖像生成數據
圖像生成語料結合了大規模真實世界圖文對、精心篩選的公開及專有來源,以及高質量合成數據。與 SenseNova U1 相比,我們新增了來自 78 個來源的約 5,900 萬組圖文對,顯著拓寬了訓練分佈,涵蓋通用場景、以人物為中心的內容、對象與材質、富文本圖像、信息圖及其他專門視覺領域。
重要的是,高分辨率樣本在整體訓練混合中佔據很大比例:有效訓練量中,約 88.2% 的分辨率超過 10242,約 64.4% 超過 20482。這使模型能夠接觸多種空間尺度下豐富的視覺統計信息,不僅為全局連貫的場景構圖與佈局提供監督,也為細粒度局部結構、紋理、材質及其他高頻視覺細節提供監督。
為改善指令對齊,我們構建了不同粒度的圖像描述,從長篇詳細描述,到簡短圖注和輕量級語義標籤。我們進一步加強中英雙語覆蓋,尤其是富文本圖像,並明確核驗提示所指定的語言與文字是否與圖像中實際渲染的內容一致。為補充真實世界數據,我們收集網絡規模的數據,並針對罕見概念、複雜布局和文字密集型設計開展定向合成。合成樣本與真實樣本均通過同一套篩選流程,聯合評估感知質量、提示保真度、文字正確性、布局質量和視覺多樣性,以確保訓練分佈具有較高質量且保持均衡。
4.2 圖像編輯數據
我們的圖像編輯語料包含約 3,800 萬個樣例,旨在覆蓋四種互補設置:通用圖像編輯、信息圖編輯、參考條件編輯,以及空間可控編輯。這些設置共同覆蓋廣泛的編輯場景,包括局部屬性修改、對象插入與移除、場景級變換、姿態和動作編輯、修復與增強、文字和布局操作、參考引導的定制化,以及區域受控操作。為提升對固定指令模式之外情況的穩健性,我們同時豐富底層視覺內容,以及編輯指令的表述方式、粒度和複雜度。對於具有挑戰性的多目標或多約束編輯,我們進一步納入結構化提示增強樣例和思維鏈樣例,明確刻畫編輯意圖、目標區域、預期屬性、空間或語義約束,以及應保持不變的內容。這種結構化監督減少了指令歧義,並為精確、忠實且重視內容保持的編輯提供更強引導。
該語料約 43% 為通用編輯,約 42% 為空間可控的信息圖編輯樣例,另有約 15% 的參考條件子集,同時支持單參考圖和多參考圖編輯。信息圖數據結合了程序化渲染的源圖—目標圖對,以及模型生成的樣例,使文字、視覺元素、布局結構和整體風格能夠得到精確操控。參考條件數據強調主體和身份保持、屬性遷移、組合融合,以及視角、姿態、幾何結構和光照等方面的可控變換,每個樣例最多包含 10 張參考圖。空間可控數據進一步通過邊界框和視覺標記引入明確的區域級引導,支持更精確、更具互動性的操作。在所有編輯設置中,數據篩選均聯合評估指令完成度、目標質量、適用情況下的參考或身份保真度,以及預期編輯區域之外內容的保持情況。
4.3 圖文交錯數據
語料中佔比最大的是面向日常生活的軌跡(約 44%),包括步驟式教程、日常場景和繪本敘事。這些樣例為交替出現的文本與圖像片段之間維持長程語義連貫性、視覺一致性及跨模態依賴提供豐富監督。信息圖數據另佔約 29%,側重結構化構圖、密集文字內容,以及語言與視覺元素的協同生成。由視頻衍生的序列約佔 19%,引入時間演化、狀態轉移和跨幀依賴。其餘約 8% 為推理密集型樣例,通過明確的中間推理加以增強,用於複雜的多步理解與生成。
我們並不將這些來源視作彼此孤立的任務集合,而是將它們轉換為一種統一軌跡格式,在其中逐步交錯排列文本狀態與視覺狀態。這種統一表述使模型能夠接觸廣泛的多模態依賴,從局部圖文對應,到長程語義推進、時間連續性,以及跨多步的推理條件化生成。值得注意的是,所有軌跡都通過一套共享流程構建,該流程結合源數據預處理、領域特定轉換或合成,以及軌跡級驗證。最終語料從語言有效性、視覺質量、跨模態一致性,以及完整多模態推進過程的連貫性和正確性等方面接受聯合篩選。
4.4 強化學習訓練數據
美學、OCR 和信息圖樣本。對於美學樣本,我們結合 HPSv3++、Pick-a-Pic、使用 Cosmos3PE 擴展的雙語提示,以及內部生成的提示,構建約 28 萬條提示,覆蓋多種主體、風格、構圖和空間配置。每條提示生成多張圖像,並使用 HPSv3++ 評分;我們移除獎勵差異較小的提示組,以保留能夠提供更具區分度的相對監督的樣例。OCR 語料包含約 6 萬條雙語文字渲染提示,中英文覆蓋保持均衡。其中包括從 Flow-GRPO 收集的約 2 萬條短文本提示,並進一步通過改寫與擴展,形成約 4 萬條文字更密集、渲染要求更複雜的長提示;從提示中提取指定文字,作為在線 OCR 獎勵計算的參考轉寫。對於信息圖樣本,第一個 GRPO 階段重用 OCR 語料,後續 GRPO 階段則按照任務特定獎勵聯合輪換 OCR 與美學提示。我們還引入了從 Linear-DPO 語料中篩選得到的約 12 萬組偏好對用於 DPO,並進一步平衡人像與非人像內容以及中英文提示,以改善整體視覺偏好對齊。
圖像編輯樣本。編輯專家在約 12 萬個樣例上訓練,其中局部編輯和全局編輯分別約佔 80% 與 20%。局部編輯包括信息圖和文件操作、場景級與對象級編輯、人物動作與姿態調整、人像修飾、文字替換、圖像修復與增強,以及以邊界框或掩碼為條件的編輯;全局編輯則側重連貫的圖像級變換。數據包含中文、英文及混合語言指令,指令長度在預定義區間內保持均衡,訓練分辨率覆蓋 512 x 512 至 2048 x 2048。數據篩選分為三個階段。首先,移除損壞、重複、低分辨率或視覺質量退化的樣本,並保留多種常見寬高比。隨後,核驗每條指令指定的實體、文字、空間區域和視覺屬性是否在源圖像中有對應依據,以及目標圖像是否忠實實現所要求的修改。最後,對源圖像和編輯後圖像的美學、技術質量,以及結構與紋理豐富度進行評估,通過保守的成對聚合方式暴露任一圖像中的不足。之後,再按任務類別和分辨率層級對保留樣本進行再平衡,形成多樣且具有挑戰性的分佈。
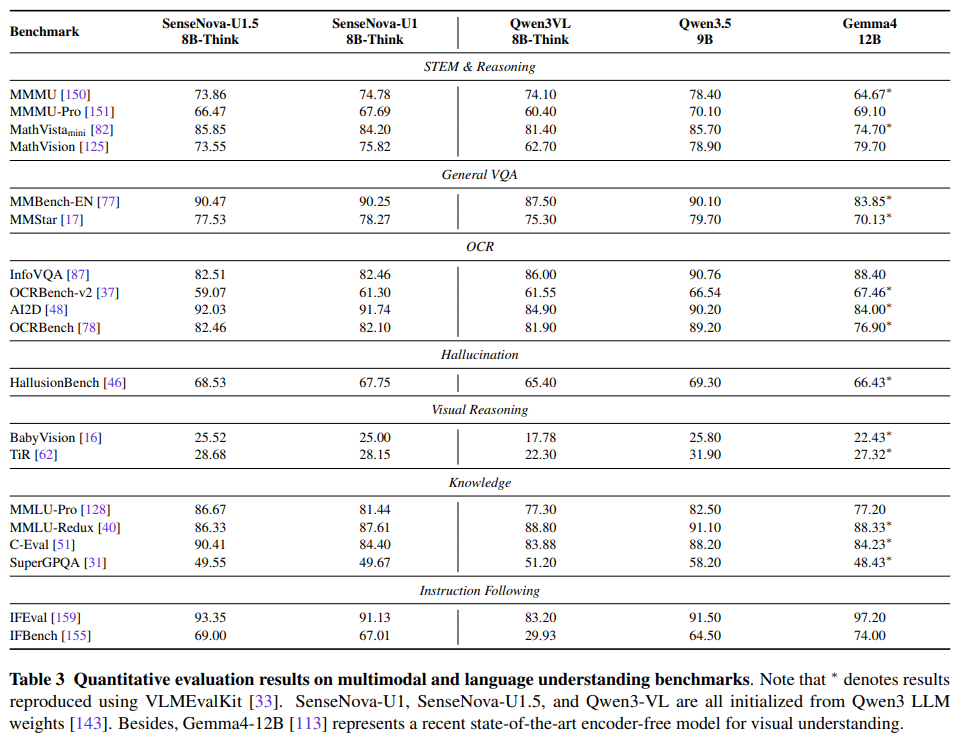
表 3 多模態與語言理解基準的定量評測結果。
5 實驗
5.1 通用理解能力評測
多模態理解。 如圖所示,SenseNova U1.5 在多種多模態基準上均展現出較強性能,涵蓋 STEM 推理、通用視覺問答(VQA)、OCR、幻覺及視覺推理。與 SenseNova U1 相比,U1.5 在大幅拓展圖像生成及編輯能力的同時,在大多數基準上保持或提升了表現,表明更強的生成建模並未以視覺理解為代價。具體而言,U1.5 在 MMMU、MathVista、MMBench、MMStar、AI2D、OCRBench、HallusionBench、BabyVision 及 TiR 上取得具競爭力的結果,並在許多任務上達到或超越 Qwen3-VL 等強大的模組化基線。值得注意的是,儘管採用不依賴外部編碼器的架構,U1.5 在多項視覺理解評測中與近期的無編碼器模型 Gemma4-12B 相比亦表現出優勢,突顯原生多模態統一對通用感知及推理的有效性。
語言理解。 除多模態能力外,SenseNova U1.5 在統一多模態訓練後,仍保留了較強的語言理解及指令遵循能力。其在 MMLU-Pro 及 C-Eval 上的表現尤為突出,分別達到 86.67 及 90.41,同時在 MMLU-Redux 及 SuperGPQA 上保持競爭力。更重要的是,U1.5 相比 SenseNova U1 顯著提升了指令遵循表現,在 IFEval 上達到 93.35,在 IFBench 上達到 69.00。這表明,U1.5 引入的視覺生成及編輯能力並未顯著削弱其底層語言能力。相反,模型在保留穩固文本推理基礎的同時,在同一統一模型內支援了範圍明顯更廣的多模態能力空間。
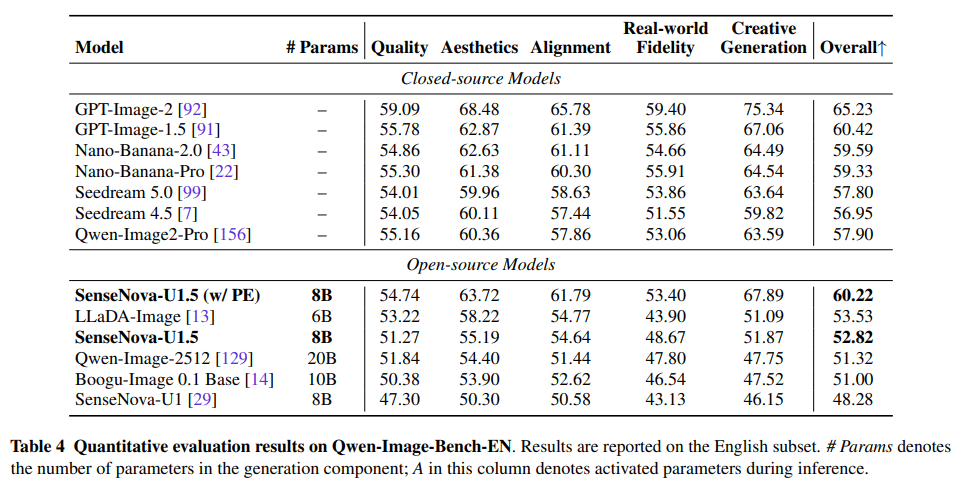
表 4 Qwen-Image-Bench-EN 的定量評測結果。
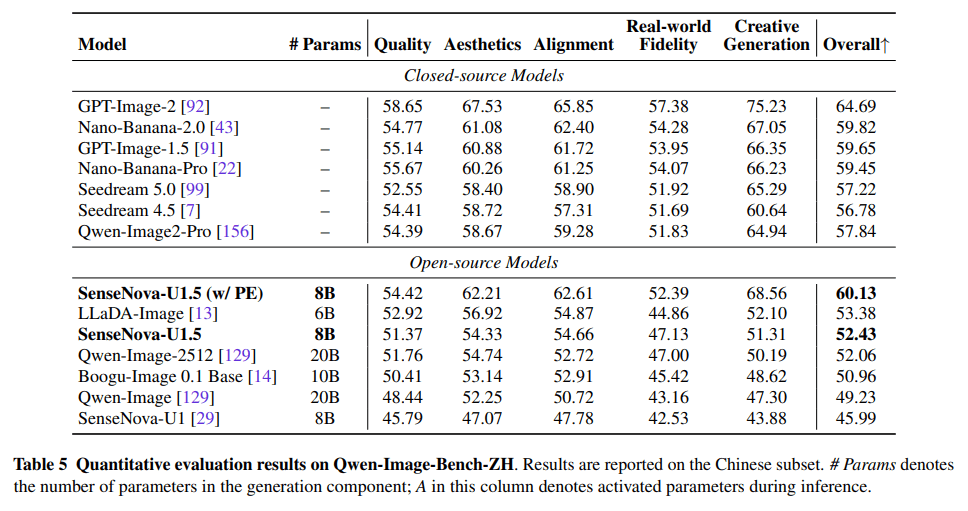
表 5 Qwen-Image-Bench-ZH 的定量評測結果。
5.2 圖像生成
通用生成。我們在 Qwen-Image-Bench、GenEval、GenEval2、DPG-Bench 及 OneIG-Bench 上評估通用文生圖能力,涵蓋視覺質素、提示對齊、組合生成、密集指令遵循、文字渲染、風格及多樣性。
Qwen-Image-Bench。如表 4 及表 5 所示,SenseNova U1.5 在 Open-Image-Bench 的英文及中文子集上均取得較強的整體表現。使用提示增強後,分數分別達到 60.22 及 60.13,在所評測的開源模型中取得最佳整體表現。即使不使用提示增強,SenseNova U1.5 亦持續優於 SenseNova U1,並與更大型的開源基線保持競爭力,展現出較強的雙語生成質素,縮小了與領先閉源系統之間的差距。
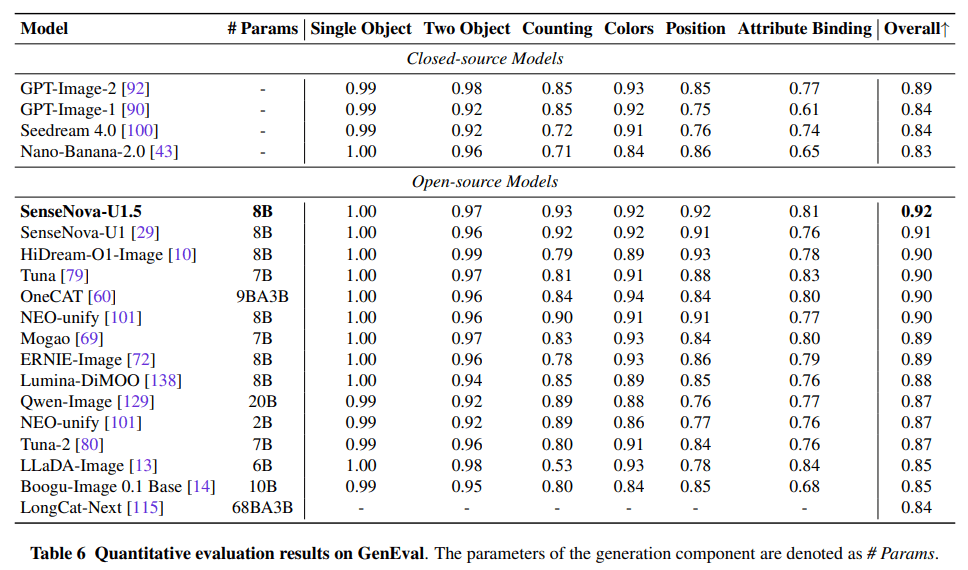
表 6 GenEval 的定量評測結果。
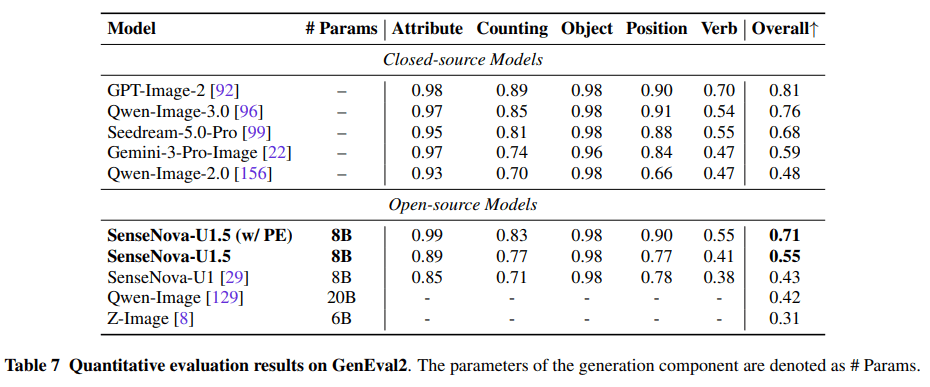
表 7 GenEval2 的定量評測結果。
GenEval。如表 6 所示,SenseNova U1.5 在 GenEval 上取得開源模型中的最佳整體表現,達到 0.92,超越 SenseNova U1 及 Qwen-Image 等更大規模基線。在計數、位置及屬性綁定方面,改進尤為明顯,同時單物件及雙物件生成表現持續保持較高水平。這些結果表明,U1.5 不僅保留了基礎物件級生成質素,亦提升了組合一致性,以及在單一提示中同時滿足多項視覺約束的能力。
GenEval2。如表 7 所示,SenseNova U1.5 在複雜約束下進一步展現出更強的組合推理及指令遵循能力。使用提示增強後,它顯著優於所有受評測的開源基線,同時進一步縮小與領先閉源系統之間的差距。屬性、計數及動詞相關生成方面的改進尤其突出,表明模型能更好地建模物件屬性、數量及互動。值得注意的是,SenseNova U1.5 更能忠實地將結構化、關係密集的提示轉換為連貫的視覺構圖,尤其是在需要同時滿足多項約束時。
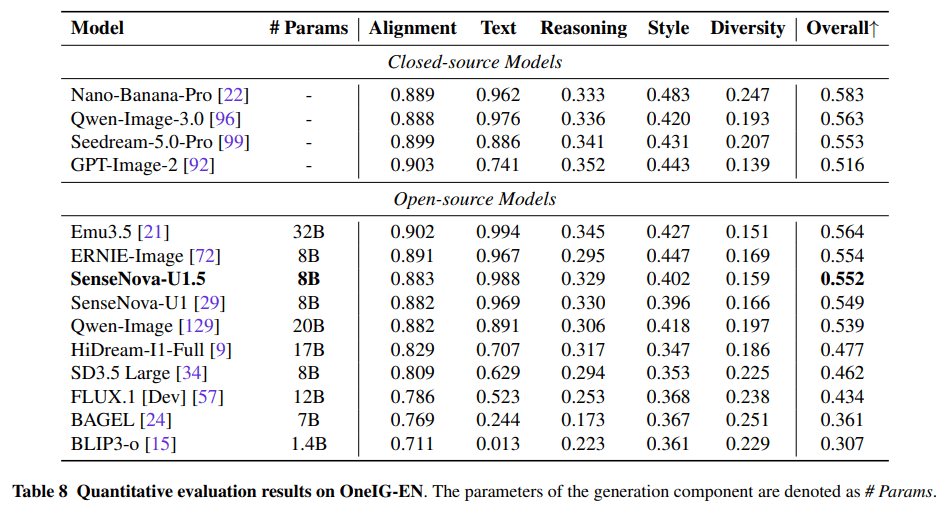
表 8 OnelG-EN 的定量評測結果。
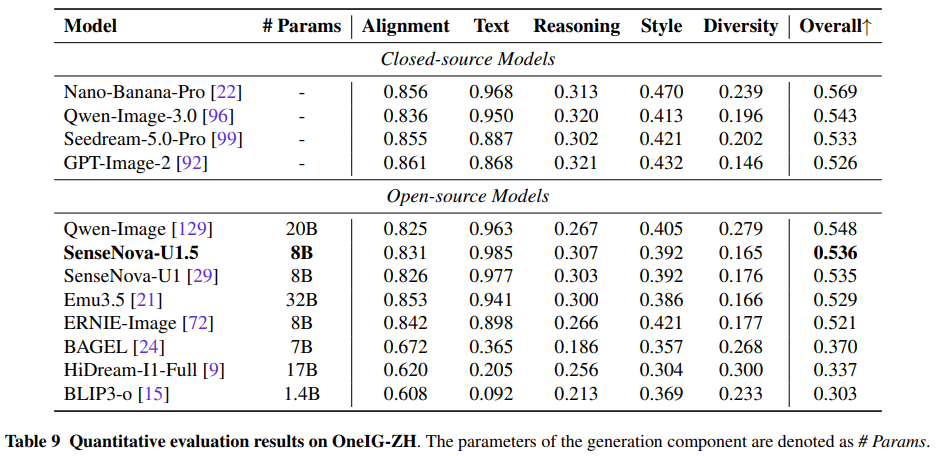
表 9 OnelG-ZH 的定量評測結果。
OneIG-Bench。如表 8 及表 9 所示,SenseNova U1.5 在英文及中文評測中展現出較為均衡的生成能力。需要指出的是,其最突出的優勢在於雙語文字中心生成。此外,儘管模型規模相對緊湊,僅為 8B,仍能在對齊、推理及風格分數上保持競爭力。這種均衡表現對實際生成場景尤為重要,因為這些場景要求準確的文字排版、語義一致性及視覺質素同時得到滿足,而非分別獨立優化。
DPG-Bench。如表 10 所示,SenseNova U1.5 的總體分數達到 88.11,位列表現最佳的開源模型之列。它在實體、屬性、關係及其他細粒度維度上均取得持續較強的結果,反映出穩固的語義落地能力及組合保真度。相比 SenseNova U1,U1.5 在提升總體分數的同時,保持了不同提示組成部分之間的均衡表現,表明它能夠更可靠地遵循複雜且結構化的指令進行生成。
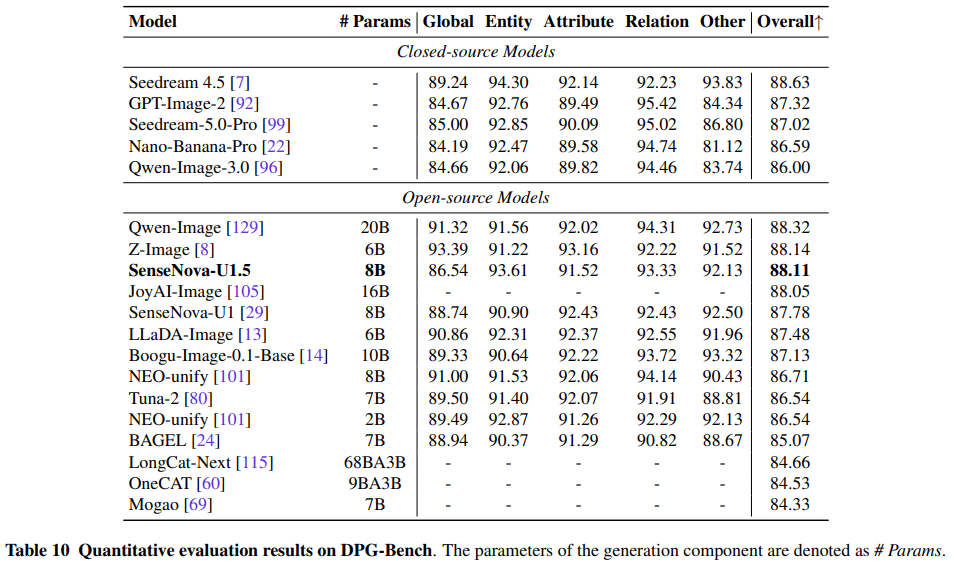
表 10 DPG-Bench 的定量評測結果。
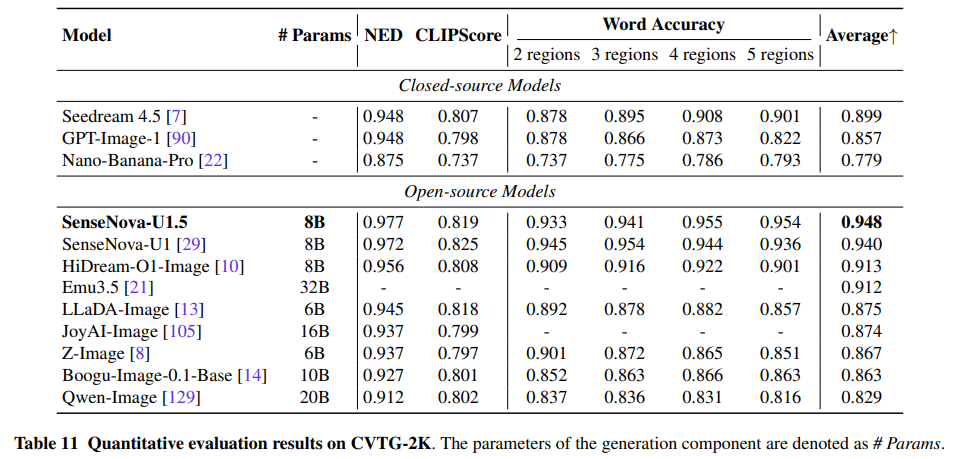
表 11 CVTG-2K 的定量評測結果。
文字中心生成。我們進一步使用 CVTG-2K 及 LongText-Bench,在要求更高的文字中心場景中考察文字渲染,重點關注多區域佈局及長篇雙語文字生成。
CVTG-2K。如表 11 所示,SenseNova U1.5 在所有受評測模型中取得最佳整體表現,平均分達到 0.948。值得注意的是,它在密集文字渲染方面展現出尤其顯著的改進,即使在更具挑戰性的四區域及五區域設定中,詞語準確率亦保持在 0.95 以上。相比 SenseNova U1,U1.5 進一步提升了 NED 及高區域數條件下的詞語準確率,同時保持相近的 CLIPScore,表明隨着渲染文字量增加,模型仍具備更強的文字保真度及穩健性。
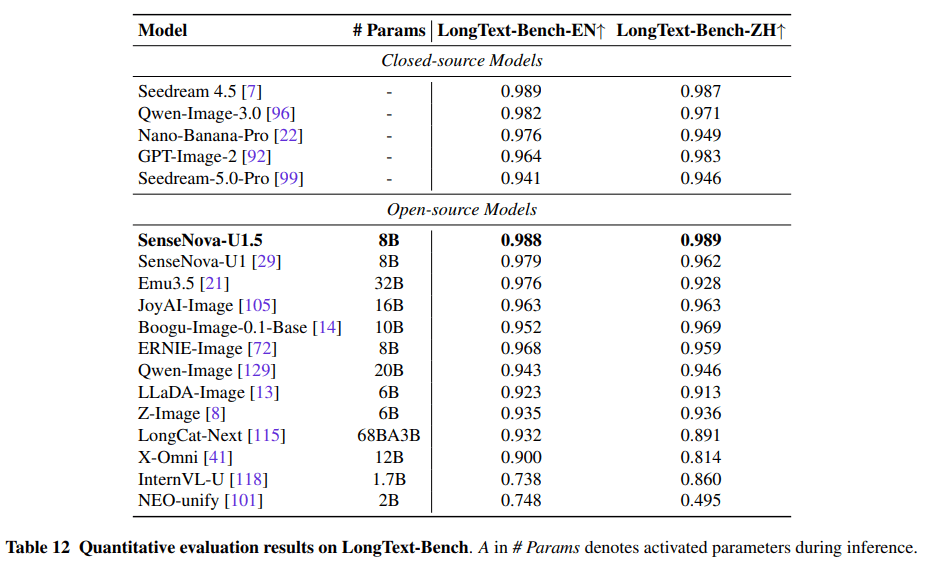
表 12 LongText-Bench 的定量評測結果。
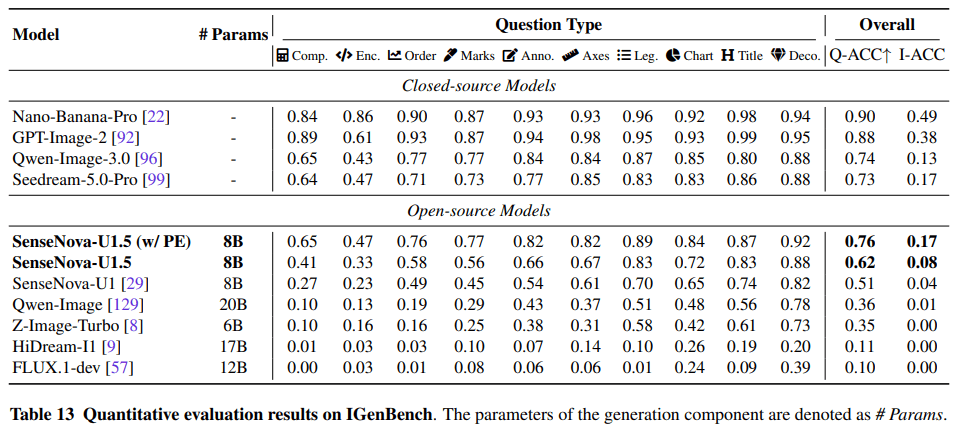
表 13 IGenBench 的定量評測結果。
LongText-Bench。如表 12 所示,SenseNova U1.5 在英文及中文賽道上均取得領先的開源表現,尤其在中文方面較 SenseNova U1 有明顯提升。隨着文字長度及佈局複雜度增加,其準確性仍然穩健,表明模型在密集、結構化及雙語文字渲染方面的穩定性有所改善。
複雜信息圖生成。我們進一步使用 IGenBench 和 BizGenEval,評估 SenseNova U1.5 在複雜信息圖表與商業內容生成方面的表現。這些基準要求模型同時滿足文字內容、佈局組織、圖表語義、視覺屬性和領域知識等要求。
IGenBench。如表 13 所示,SenseNova U1.5 在不使用提示增強時,已取得最強的開源表現,加入 PE 後更進一步提升。這些改進表明,模型的信息圖表生成更加可靠,結構化視覺規劃能力更強,但與最強專有系統之間仍存在差距。
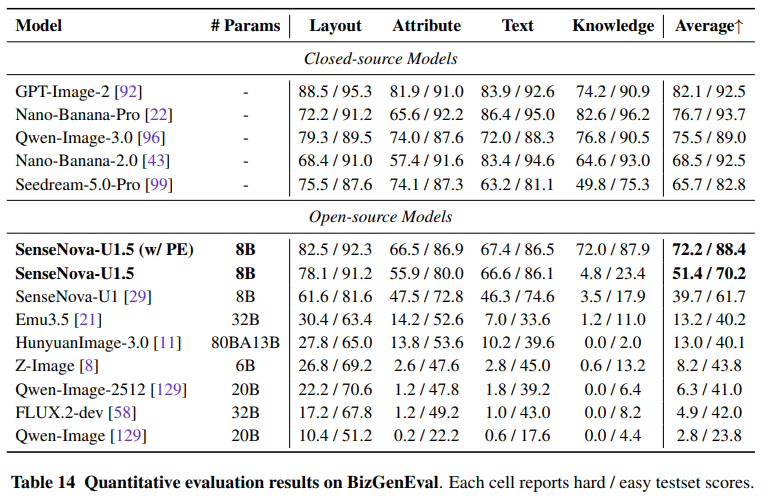
表 14 BizGenEval 的定量評測結果。
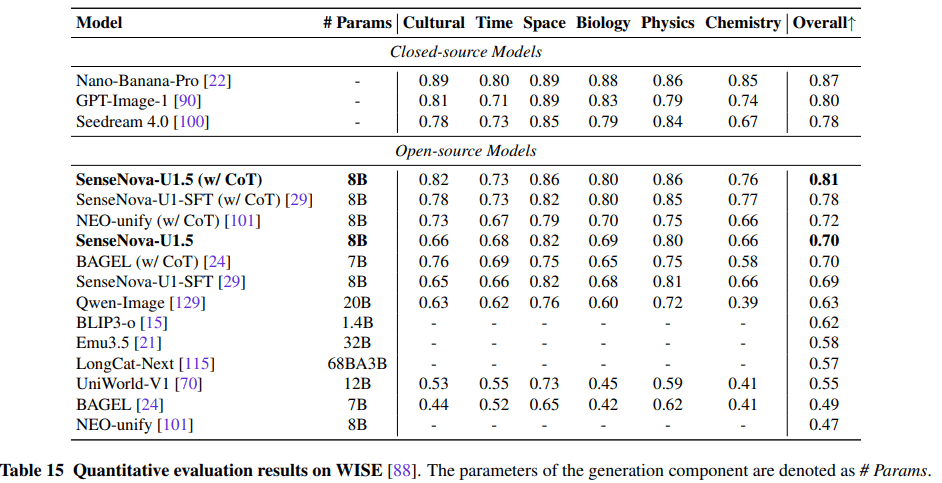
表 15 WISE 的定量評測結果。
BizGenEval。如表 14 所示,SenseNova U1.5 在簡單與困難劃分上均顯著優於 SenseNova U1,使用提示增強後更進一步達到領先的開源表現。這些增益在知識密集型樣例中尤為明顯,同時在佈局、屬性和文字相關維度上也保持一致。
以推理為中心的生成。 我們進一步使用 WISE 評估知識密集型和推理密集型生成能力,涵蓋文化知識、時間、空間、生物、物理和化學。
WISE。如表 15 所示,SenseNova U1.5 在不使用思維鏈(chain-of-thought,CoT)推理時已具備競爭力;啟用 CoT 後,性能顯著改善,並取得領先的開源表現。文化知識、生物和化學等知識密集領域的收益尤其明顯,突顯了顯式推理在使視覺生成植根於世界知識方面的價值。
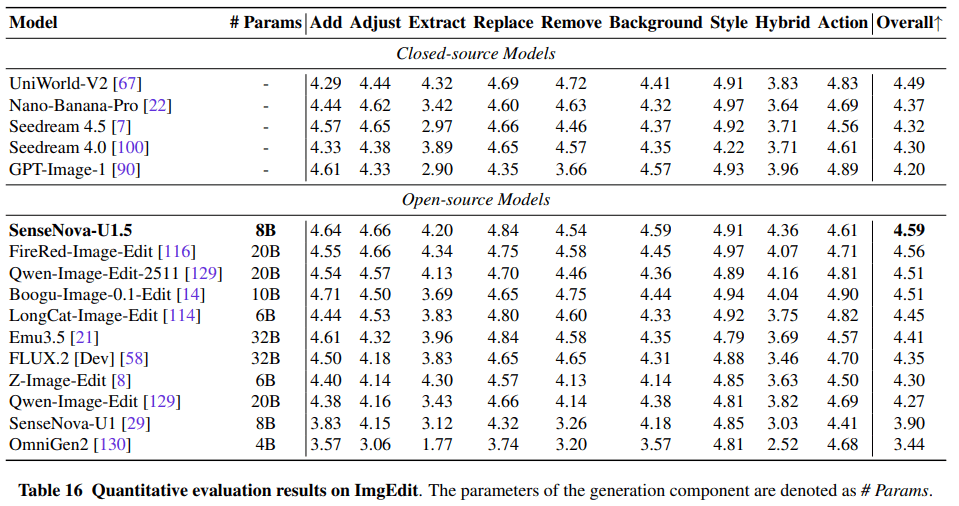
表 16 ImgEdit 的定量評測結果。
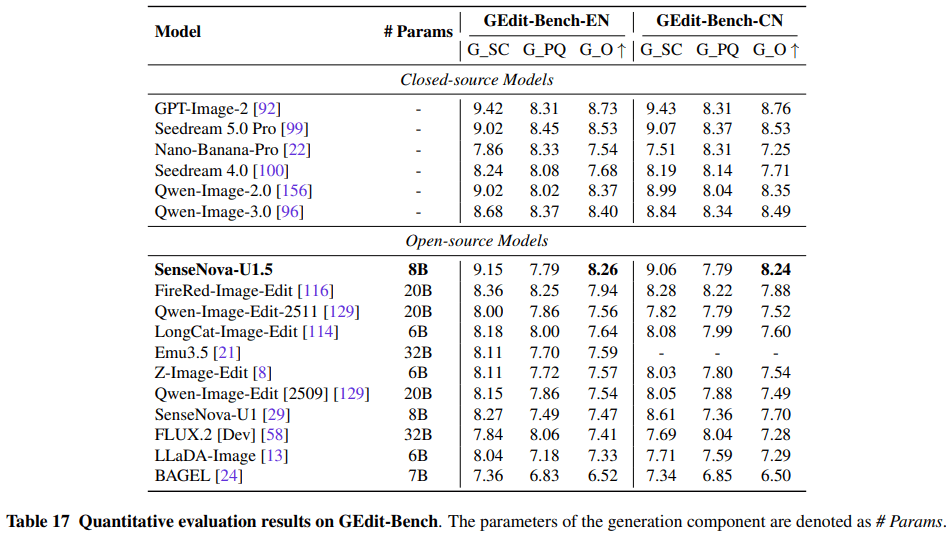
表 17 GEdit-Bench 的定量評測結果。
5.3 圖像編輯
通用編輯。我們在 ImgEdit、GEdit-Bench、WeEdit 和 OmniRef-Bench 上評估通用編輯能力,涵蓋多種編輯類型、語義一致性、文字中心編輯和基於參考圖像的編輯。
ImgEdit。如表 16 所示,SenseNova U1.5 在廣泛的編輯類型上取得領先的整體表現,相比 SenseNova U1 有顯著提升。這些改進在各類別間具有一致性,表明模型在保持來源圖像內容與視覺質素的同時,具備更強的編輯執行能力。
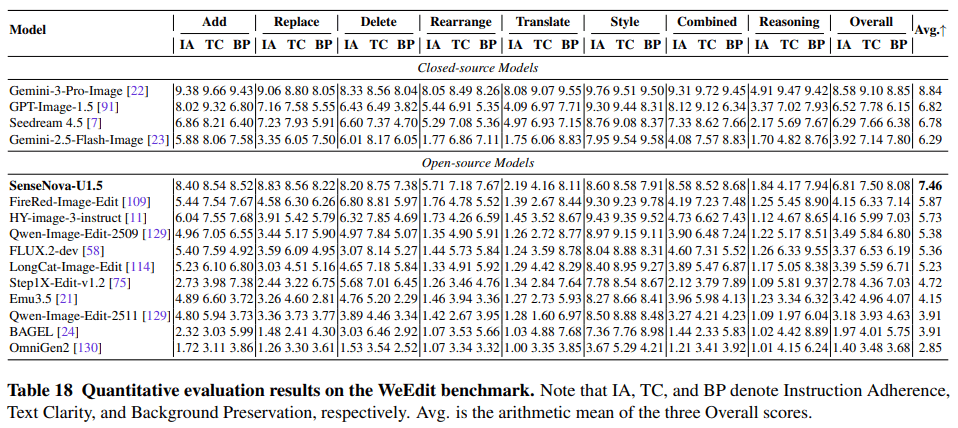
表 18 WeEdit 基準的定量評測結果。
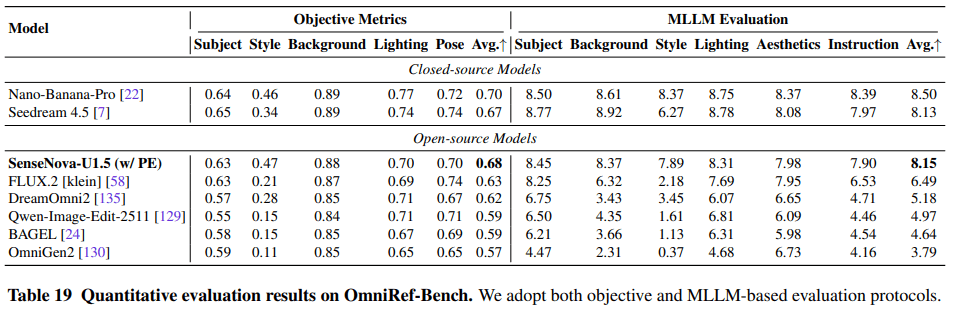
表 19 OmniRef-Bench 的定量評測結果。
GEdit-Bench。如表 17 所示,SenseNova U1.5 取得最強的整體表現。這些收益在語義一致性方面尤為明顯,表明模型能夠更可靠地識別預期編輯、修改正確的視覺內容,並保留原圖的語義上下文。同時,U1.5 在感知質素方面保持競爭力,說明更好的指令執行並未以視覺真實感或局部連貫性為代價。這反映了編輯正確性、內容保留與整體圖像質素之間更好的平衡。
WeEdit。如表 18 所示,SenseNova U1.5 顯著優於其他開源模型,並與領先專有系統保持競爭力。其較強的指令遵循、文字清晰度與背景保持表現,展示了穩健的文字中心編輯能力:準確執行所要求的文字修改,同時使無關視覺內容保持完整。結果進一步表明,語義編輯與視覺重建之間的協同有所改善。不過,翻譯相關和推理密集型編輯仍相對困難,說明需要更深層語言與上下文理解的任務還有進一步提升空間。
OmniRef-Bench。如表 19 所示,在客觀指標和基於多模態大型語言模型(MLLM)的兩種評估協議下,SenseNova U1.5 都在 OmniRef-Bench 上取得領先的開源表現。風格一致性與背景保持方面的增益尤為顯著,表明模型能夠更有效地利用參考信息,同時盡量減少對目標圖像的非預期修改。此外,較強的主體和姿態一致性表明,在多種編輯條件下,身份、外觀及結構線索都能得到可靠保留。這些結果說明,U1.5 不僅提高了參考保真度,也在參考利用、變換準確性與原始場景保持之間實現了更好的平衡,這對於穩健的多參考圖像編輯和定制化編輯至關重要。
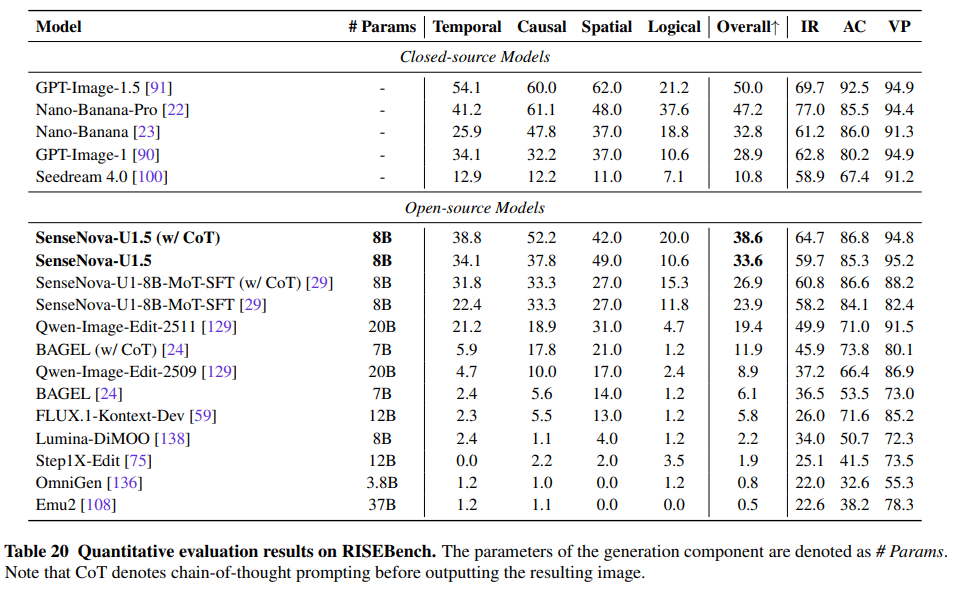
表 20 RISEBench 的定量評測結果。
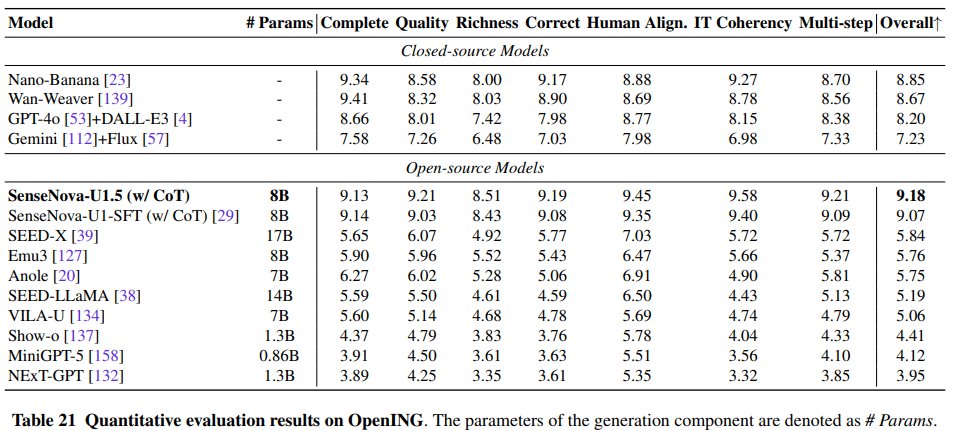
表 21 OpenING 的定量評測結果。
以推理為中心的編輯。除直接遵循指令外,我們進一步使用 RISEBench,評估模型在修改圖像之前必須推斷時間、因果、空間或邏輯後果的編輯任務。
RISEBench。如表 20 所示,即使不使用 CoT,SenseNova U1.5 已優於所評測的開源基線,而顯式推理又帶來了進一步的顯著提升。增益在因果、邏輯和時間編輯中最為明顯,說明當所需變換必須先通過推斷確定,而不能直接定位時,CoT 尤其有效。相比之下,空間編輯的收益並不那麼穩定,這表明顯式推理對隱含的多步變換更有價值,而非對能夠直接獲得視覺依據的編輯同樣有益。
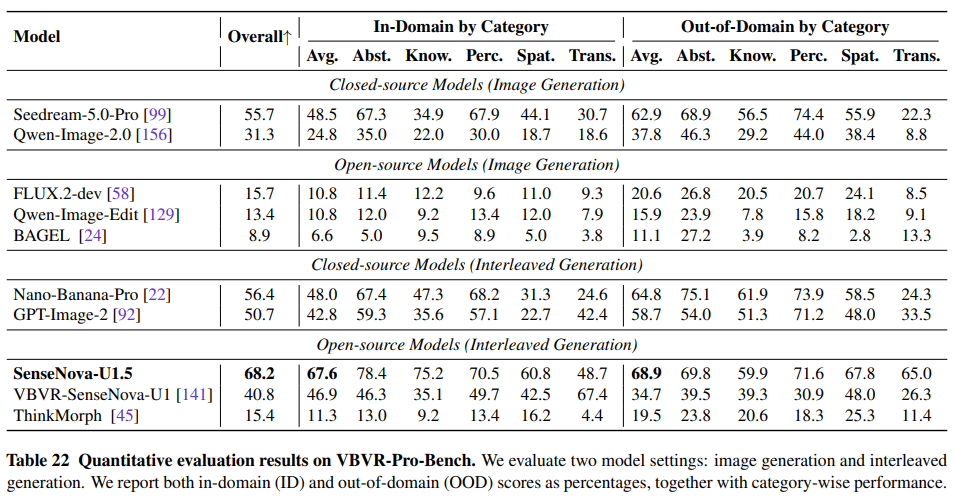
表 22 VBVR-Pro-Bench 的定量評測結果。
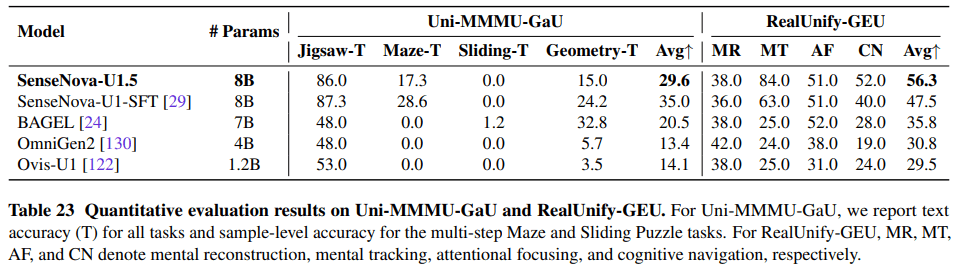
表 23 Uni-MMMU-GaU 與 RealUnify-GEU 的定量評測結果。
5.4 交錯生成
交錯生成。 我們在 OpenING 和 VBVR-Pro-Bench 上評估這項能力。這些基準整合理解、推理與生成,用於開放式交錯生成,以及以生成為中介的視覺推理。
OpenING。如表 21 所示,使用 CoT 的 SenseNova U1.5 在 OpenING 上取得領先的整體表現,優於 SenseNova U1,也超越了所比較的專有系統流水線。在圖文連貫性、人類對齊和多步一致性上的較強結果,展示了可靠的開放式交錯生成能力。
VBVR-Pro-Bench。如表 22 所示,SenseNova U1.5 在不同認知能力上取得新的最先進結果,展示了通過交錯文字—圖像生成直接開展推理的能力。它還對域外任務表現出較強泛化能力,優於 Nano-Banana-Pro 和 GPT-Image-2 等領先專有模型。
統一推理。 Uni-MMMU 評估生成輔助理解(generation-aided understanding,GaU),而 RealUnify 從重建、追蹤、聚焦與導航等方面評估生成增強理解(generation-enhanced understanding,GEU)。
Uni-MMMU-GaU 與 RealUnify-GEU。 如表 23 所示,SenseNova U1.5 在 RealUnify-GEU 上取得領先表現,相比 SenseNova-U1-SFT 有大幅提升;同時,在 Uni-MMMU-GaU 上與上一代 SenseNova 模型保持競爭力。這些發現表明,在 SenseNova U1.5 中,生成不僅是一種輸出模態,也可以充當支援多模態推理與理解的中間表示。
6 結論
我們提出 SenseNova U1.5,進一步邁向這樣的原生多模態系統:視覺理解與生成在共同的計算基礎內學習,而不是通過彼此分離的感知與生成流水線連接起來。廣泛的實驗結果表明,這一方向能夠擴展到基礎圖像合成之外:緊湊的原生表示能夠在維持較強理解能力的同時,有效支援高保真生成、編輯、交錯生成,以及推理密集型視覺任務。
從更廣泛的角度看,SenseNova U1.5 表明,多模態統一的核心價值不在於架構簡化,而在於能力互動。推理能夠改善視覺內容的創建與變換方式,而生成本身也可以成為模型解決視覺問題時內部過程的一部分。這模糊了感知與創作之間的傳統界線,並指向一類新的基礎模型:在這些模型中,「看」、「推理」和「生成」不再作為鬆散耦合的功能進行訓練,而是湧現為共享視覺智能的不同表現形式。我們認為,這是邁向一類多模態模型的重要一步:它們不僅僅組合不同模態,而是發展出用於解釋、想像並作用於視覺世界的統一機制。