




 リターンマッチ
- ニュース
SenseTime首席科学家 Lin Dahua:マルチモーダルの能力創発の瞬間は1~2年以内に到来する
編集者注
編集者注:
Coding Agentがビジネスの一連のサイクルを実現し、AIがビジネス価値を創出する明確な道筋を業界に示しました。しかし、AGIへと続く可能性はCodingにとどまりません。今回のインタビューで、SenseTime 共同創業者兼チーフサイエンティスト Lin Dahuaは、今後1~2年でマルチモーダルがCode Agentの爆発的な発展に似た重要な転換点を迎え、能力創発の瞬間を越えるとの見方を示しました。
コンピュータービジョンを起点とするSenseTimeは、ネイティブ・マルチモーダルと空間知能に継続的に注力してきました。Uシリーズ、SenseNova 6.8、Raccoon Workなどのアプリケーションは、モデルからプロダクトまで幅広く展開されています。視覚、言語、推論、行動が真に融合してこそ、AIは現実の場面へ進出できます。
36Krからの転載です。マルチモーダルの能力創発の瞬間を、皆さまとともに見届けられることを楽しみにしています。
文|Li Zhaofeng
編集|Zhang Yuxin
「コンピューターのない時代にも、アインシュタインやニュートンはいました。彼らがコードを書かなかったからといって、知性が足りないとは考えません。」
先日、SenseTime 共同創業者兼チーフサイエンティスト Lin Dahuaは、36Krのインタビューでこの言葉を用いて、Codingと知能の上限の関係を説明しました。同時に、SenseTimeがなぜ今なおネイティブ・マルチモーダルを長期的な方向性としているのかも明らかにしました。
現在、Coding Agentは比較的早い段階でビジネスの一連のサイクルを実現しています。公開情報によると、7月末時点でAnthropicの年換算収益は650億ドルを超え、2025年末の約7倍に達しました。マルチモーダルが同じように明確な能力とビジネス成果をいつ示せるのか。それが今回の対話で繰り返し取り上げられた問いでした。しかし長期的な視点では、Lin Dahuaは「AIとAGIの可能性はCodingにとどまらない」と考えています。
AGIを目指すうえでのマルチモーダルの位置付けについて、DeepSeek創業者のLiang Wenfengは、マルチモーダルは最終的に実現するものの、それ自体を知能と捉えるのではなく、1つの「コンポーネント」と見なすと述べています。
ほぼ同じ時期に、NVIDIA創業者兼CEOのJensen Huangは、ロボットと自動運転向けの世界基盤モデルCosmos 3を発表しました。このモデルは、視覚推論、環境シミュレーション、行動予測を同一のアーキテクチャに組み込んでいます。Jensen Huangは、Cosmos 3について「理解と推論ができ、生成も可能で、シミュレーションのループに入ることもでき、さらにはそのままポリシー自体になることもできる」と述べています。
Lin Dahuaの見方では、これはどちらが正しいかという問題ではありません。各社が直面する課題、リソース、長期的なビジョンが異なるため、選択もおのずと異なります。
コンピュータービジョンを起点とするSenseTimeは、大規模モデルの段階に入った後、この技術の蓄積をネイティブ・マルチモーダルと空間知能へと広げました。そのためマルチモーダルは、モデルとプロダクトの展開を貫く中核的な軸となっています。
SenseTimeのモデル・マトリクスにおいて、SenseNova 6.8シリーズはマルチモーダル・エージェントモデルであり、長期タスクの計画、実行、複数Agentの協調を担います。Uシリーズは、理解と生成を統合したネイティブモデルで、視覚理解、生成、編集に重点を置き、動画や3次元へと展開しています。アプリケーション層では、Sekoはストーリー、絵コンテ、動画生成をつなぐAIショートムービー制作エージェントです。Raccoon Workは、オフィス業務やデータ分析などのタスクに対応するAIオフィスエージェントです。
今年4月、SenseTimeはSenseNova U1ネイティブ理解生成統合モデルを発表し、オープンソース化しました。一般的な視覚言語モデルとは異なり、U1は独立した視覚エンコーダーとVAE(変分自己符号化器)を取り除き、1つの自己回帰アーキテクチャで言語、視覚意味、ピクセル生成を統合的に処理します。
その約4カ月後、SenseTimeはU1.5 Liteを発表し、このアーキテクチャを理解と生成から連続編集へと拡張するとともに、高解像度生成と複雑な指示の制御を強化しました。
SenseTimeが最新発表した2026年中間決算では、上半期の売上高は29.1億元で、前年同期比23.4%増となりました。生成AIの売上高は23.3億元で、全体の約8割を占めています。
AI事業の成長に後押しされ、SenseTimeは初めて国際財務報告基準(IFRS)に基づく黒字化を達成し、マルチモーダル分野への長期的な技術投資により多くの余地を確保しました。
以下、インタビュー全文:
01
核心はCodingではなく、長期的な思考にある
36Kr:Liang Wengfengはマルチモーダルを検索に似た「コンポーネント」と捉え、知能の上限を高める主軸とは考えていません。一方、あなたはマルチモーダルが十分に融合すれば、単独の言語モデルは不要になると判断しています。対立点はどこにあるのでしょうか。
Lin Dahua:私は実際、DeepSeekにはとても敬意を抱いています。どの企業にも自社の主力分野が必要です。DeepSeekは言語能力とCoding能力を業界トップクラスにすると同時に、モデルアーキテクチャを最も効率的なものにしようとしています。DeepSeekの立場からすれば、この選択は非常に合理的です。画像を処理する必要がある場合も、マルチモーダルのコンポーネントを接続すればよく、少なくともプロダクトの機能は揃います。
SenseTimeが向き合う課題は少し異なります。オフィス業務、医療、小売、ロボット、世界モデルのいずれにも、視覚信号を欠かすことはできません。私たちは早くから、視覚と言語の統合モデリングが、人工知能が現実の産業や物理世界へ進出するための基盤だと考えていました。
SenseTimeもCodingに取り組んでおり、プログラミング能力をモデルの重要な基盤能力と捉えています。しかし、複雑なソフトウェアエンジニアリングを唯一の主力分野にすることはありません。
さらに掘り下げると、重要なのは知能の上限をどのように理解するかです。Coding能力の高さは知能レベルが向上した結果ですが、知能の核心はCodingという仕事の形態ではありません。複雑な情報を集約し、長期的な思考、推論、実行、修正を行うことにあります。
36Kr:長期的な知能が現実世界に進出するには、ネイティブ・マルチモーダルが必要条件なのでしょうか。
Lin Dahua:モデルがコードを書くことだけを行うのであれば、マルチモーダルは必ずしも必要条件ではありません。しかし、タスクがCodingからより幅広い業界や現実世界へと移ると、多くの場面でマルチモーダルが不可欠になります。
Codingは現在、データ環境が最も整った、長期的な思考能力を体現する媒体です。GitHubには大量のプロセスデータがあり、コードは実行でき、テストケースから確定的なフィードバックも得られます。その背景には成熟したソフトウェアエンジニアリング市場もあるため、Codingは訓練とビジネスの一連のサイクルを最も早く実現しました。
しかし、人工知能はCodingだけにとどまりません。フロントエンド開発であっても、モデルはコードを書き終えた後にページをレンダリングし、見栄えがよいか、明らかな誤りがないかを確認する必要があります。これにも同じく視覚能力が求められます。
36Kr:MLLM(マルチモーダル大言語モデル)やネイティブ・マルチモーダルに取り組む研究者と話した際、視覚データを加えると事前学習と後学習の難度が大幅に高まり、比率の調整を誤れば言語、数学、推論能力が低下する可能性もあると聞きました。ネイティブ・マルチモーダルモデルの訓練の難度とコストについて、どのようにお考えですか。
Lin Dahua:言語モデルに視覚エンコーダーを1つ接続するだけなら、推論時に増える計算量は、数百B、さらには1Tパラメータの言語バックボーンと比べれば、実際には取るに足りません。本当に難しいのは訓練です。
まずはデータの配分です。モデルに視覚能力を加えるには、対応するデータを追加すると同時に、既存の言語、数学、推論能力が低下しないようにする必要があります。これが私の言うAlignment Tax(アライメント税)です。単に比率を1:9から2:8に変えるだけではなく、大量の比較実験も必要です。モデルをアップデートするたびに、配分も再調整する可能性があります。
次に強化学習です。新たなモダリティを導入すると、訓練目標と技術的アプローチが複雑になります。また、視覚関連タスクに対するフィードバック信号を構築すること自体も、いまだに未解決の問題です。最もコストがかかるのは、最後の大規模訓練ではなく、前段階で手法を模索する時間であることが少なくありません。モデル企業にとって、問題は必ずしも費用を支払えないことではありません。実験をもう1ラウンド行うだけで、モデルの開発が競合他社より1カ月遅れる可能性があるのです。
これが、私たちがまず8Bパラメータの軽量モデルで反復を進めている理由です。理解と生成の統合という道筋はまだ完全には収束していません。まずアーキテクチャ、データ配分、訓練方法を安定させてから規模を拡大するほうが、結果的に効率が高くなります。
△キャプション:U1 Proによる画像生成
02
画像生成は最初に解き放たれた能力であり、終着点ではない
36Kr:現在、U1とU1.5は主に画像生成に使われています。ユーザーにとって、従来の視覚エンコーダーに依存しないこの統合アーキテクチャは、専用モデルでは実現できないどのような体験をもたらすのでしょうか。
Lin Dahua:ユーザーにとって最も直接的な変化は、モデルがまず内容を理解し、その後でどのように生成するかを決めることです。複雑な情報がいくつか示された場合、どの内容が重要かを判断したうえで、構成やレイアウト、ビジュアル表現を組み立てます。インフォグラフィックは、理解・推論・生成をまさにつなぎ合わせる必要があるため、私たちはまずこの領域から取り組み始めました。
Uシリーズには、さらに長期的な目標として、空間知能とフィジカルインテリジェンスがあります。私たちは、空間知能と画像生成を同時に開発することも検討しました。しかし、モデルに能力を一つ追加するたびに、トレーニングの複雑さは大きく増します。そこで当時は、より複雑な空間知能はいったん保留し、U1によって理解と生成を統合する道筋を確立することを優先しました。そして、言語とビジュアル要素を一つの表現空間でどのように融合するかについて、技術的な知見を蓄積しました。
長期的な技術開発において、3年間ひたすら取り組み、途中の成果を何も発表しないわけにはいきません。SenseTimeは上場企業であり、ユーザーが実感でき、業界にとっても価値のある成果を継続的に示す必要があります。画像生成は、この道のりで最初に実現した能力であって、終着点ではありません。
36氪:U1.5では、文字生成、美的センス、継続的な編集が重点的に向上しました。これによって、従来の「ガチャ」のような画像生成プロセスはどのように変わるのでしょうか。
Lin Dahua:U1のリリース後、実際に使用する中で、文字生成と局所的なディテールにはまだ改善の余地があることが分かりました。4月から6月にかけてインフォグラフィック版を継続的に改良し、文字を段階的に正確なものへと修正していきました。その後、文字がすべて正しくても、画像が学生の作ったPPTのようで、デザイン性に欠ける場合があることにも気付きました。そこで本物のデザイナーに参加してもらい、美的センスという課題を補いました。美的センスと論理的能力は別のものです。コーディングと美的感覚も別のものです。どれほど強力なモデルでも、美的感覚が自動的に生まれるわけではありません。
文字が正確で、画面が美しくても、解決できるのは単回の生成品質にすぎません。実際のデザインは、一度生成したら終わりではありません。構図全体や修正内容に関する指示は、1,000~2,000字に及ぶこともあります。モデルはこうした制約を理解するだけでなく、指定された領域だけを変更し、その他の部分にはできるだけ手を加えない必要があります。
従来の一度きりの生成は、いわば「ガチャ」のようなものでした。画像を5枚連続で生成しても、それぞれ別の箇所で間違い、使える画像が1枚もないことがあります。継続的な編集なら、ユーザーはすでに正しい部分を残したまま、問題のある箇所だけを修正できます。
継続的な編集は基盤となる能力です。これを軸にすることで、要求の理解、コンテンツの生成、繰り返しの修正を一つのループにつなげられます。これが私たちの言うAgentic Generation(エージェント型生成)です。モデルは同じ作品を中心に継続的なイテレーションを行い、納品できる状態になるまで改善します。
36氪:テンセントのYao Shunyuは、ユーザーは最も強力なモデルに対して料金を支払う意思があると述べています。企業がコストパフォーマンスを判断する際も、まず性能を見る必要があります。モデルの価格が高くても、一度で正しく仕事を完了できるため、結果的にコストを抑えられる場合もあります。U1.5 Liteはコストパフォーマンスを重視し、U1 Proは能力の上限を追求しています。SenseTimeは、この2種類のニーズをどのように捉えていますか。
Lin Dahua:まず、モデルがユーザーにとって本当に使える水準に達していなければ、価格について議論する意味はありません。U1.5 Liteは8Bパラメータのオープンソースモデルで、効率とコストパフォーマンスをより重視しており、日常的な大量のタスクに適しています。U1 Proが追求するのは能力の上限であり、コストははるかに高くなりますが、プロフェッショナル水準の成果を提供することを目標としています。
これは、携帯性に優れたカメラとプロ向けの一眼レフカメラの違いに少し似ています。最高水準の成果のために高い料金を支払う人もいれば、効率をより重視する人もいます。Lite版は細部に瑕疵が生じる確率がやや高いかもしれませんが、修正しやすく、もう一度ガチャを引く必要はありません。2つの製品は、それぞれ異なるニーズに対応しています。
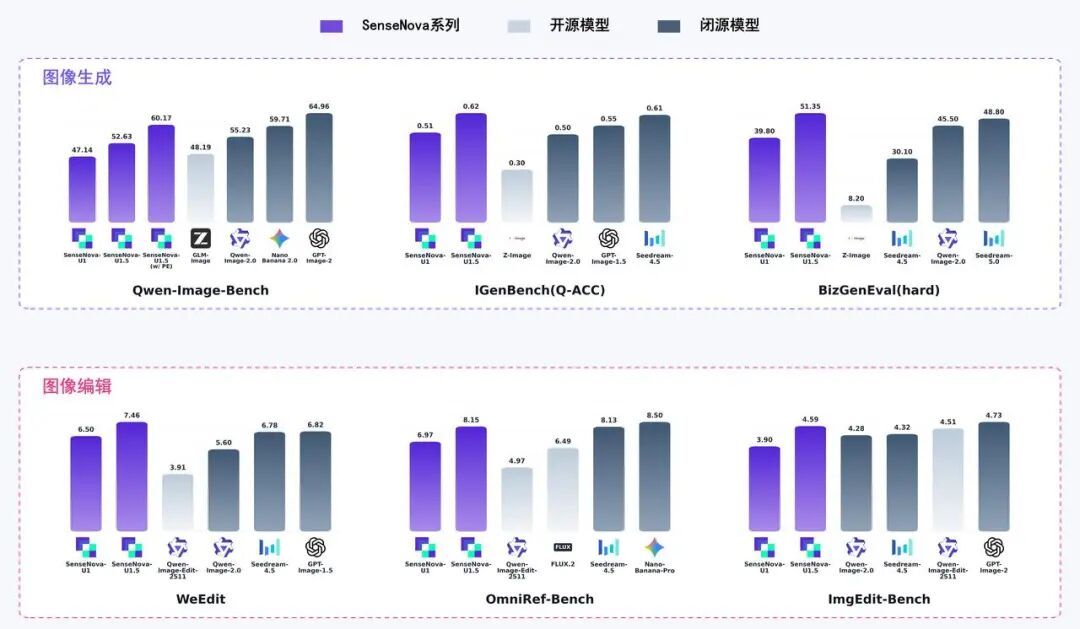
△SenseTimeのSenseNova U1.5 Liteモデルによる複数のビジョンタスクでの性能
36氪:企業は、汎用大規模モデル1つにタスクを任せることも、エージェントに複数の専門モデルをディスパッチさせることもできます。実際のワークフローでは、どちらの方法がより経済的でしょうか。
Lin Dahua:モデルにはまず、基本的な能力を一通り備えさせ、そのうえで専門性を発揮させる必要があります。ここには不可能の三角形があります。それは、能力の広さ、専門性の深さ、そしてコストです。広さと深さを兼ね備えたスーパー・モデルを作ることはもちろん可能ですが、必ず非常に大きく、高価になります。
企業も、すべての職種に「超人」を1人ずつ雇うことはありません。現実的には、異なる専門分野のモデルでチームを構成します。もちろん、ここでいう各モデルも、健全な基本的知能を備えている必要があります。
SenseTimeにとって、SenseNova 6.8(マルチモーダルエージェントモデル)は管理者に近い存在です。長期的なタスクと、複数の専門エージェントの協働を担います。このエージェントには、画像を見て理解し、次の行動を決めるための「目」も必要です。一方、Uシリーズはビジョン領域の専門家に近く、精細な視覚認識、制御可能な生成、空間知能を非常に高い水準まで引き上げます。両者はそれぞれの役割を担い、協力してタスクを完了します。
36氪:SenseTimeのAIコンテンツ制作プラットフォームSekoは、動画制作を完結できるほか、Seedanceなどの専用モデルを接続することもできます。単一の動画生成モデルと比べて、Sekoはどのような課題の解決を目指しているのでしょうか。
Lin Dahua:Sekoが提供するのは、動画制作の完全なプロセスです。ただし、すべての工程をSenseTime独自のモデルで実行する必要はありません。最終的な動画のレンダリングにはSeedanceなどの専用モデルを呼び出せます。物語をどのように展開するか、絵コンテをどのように生成するか、結果を確認した後にどのように調整するか。この制作とイテレーションのループ、つまり制作プロセスこそが、クリエイターの知的能力を真に反映する部分であり、私たちが重点的に掌握したい領域です。
動画の画質は、大部分が高品質なデータとリソースの投入に左右されます。SenseTimeがより重視しているのは、モデルに制作意図を理解させ、どこを調整すべきかを判断させ、理解・生成・修正をつなげることです。これが、Sekoと専用動画生成モデルの役割分担における違いでもあります。
03
空間知能はまだGPTの瞬間を迎えていない
36氪:画像生成、動画生成、3D、空間知能はいずれも継続的な投資を必要とします。リソースが限られている場合、SenseTimeはどの能力に注力するかをどのような基準で決めるのでしょうか。
Lin Dahua:私たちが本当に注目しているのは、2つの関係です。言語知能はビジュアルな想像力と生成に影響を与えられるのか。そして、ビジュアルな生成と想像力は、逆に推論に影響を与えられるのか、ということです。
そのため、投資においては、上述した2つの問いに対する私たちの理解を深められる取り組みに重点を置いています。
画像生成、動画、3Dは異なる方向に見えますが、基盤ではいずれもこの2つの関係を扱っています。したがって、すべての指標を極限まで高めようとは考えていません。たとえば動画では、映画品質の画質を最大の競争軸にはしません。人物画像の生成も引き続き取り組み、主に生成品質を保証しますが、最も中核的な方向にはしません。
生成に取り組む際、私たちはインフォグラフィックを重点シーンとして選びました。限られた画面の中で情報をどのように効果的に整理し、伝えるかを判断するために、本当の知能が必要だからです。オフィス業務に取り組む際も、データ分析と予測を特に重視しています。これは知能水準が強く試される領域であり、知能の上限を引き上げる原動力になります。
誰もがコーディングに躍起になっているとき、私たちはむしろ自分たちのペースで取り組めます。もし全員が空間知能の開発に転じれば、私たちのプレッシャーはもう少し大きくなるかもしれません。
36氪:1年前、ある業界関係者は世界モデルを「GPT-3段階」にたとえました。現在、真の汎化を実現するまでには、あとどれくらいかかるのでしょうか。
Lin Dahua:具体的なシーンで使えるものはすでに数多くあります。ただ、まだ汎化はできません。あるシーンを与えれば、現在のVLA(Vision-Language-Action)やWAM(World Action Model)は非常に専門的な対応ができます。しかし別のシーンに移ると、モデルには基本的な判断力さえ残っていない場合があります。
真のGPTの瞬間には、広さと深さを同時に実現する必要があります。広さとは、多くのシーンに移っても理解できることです。深さとは、長期的な思考と行動を継続して完遂できることです。空間能力は複雑なロジックとも結び付かなければなりません。そうでなければ、タスクの途中で突然考えられなくなり、依然として商用化は困難です。
一定の汎化能力を備えたシステムが登場するには、あと1~2年は必要だと思います。モデルの能力は少しずつ向上していくもので、ある日突然切り替わるわけではありません。
36氪:世界モデルと空間知能は、一般にデータによる制約を受けると考えられています。本当に不足しているのはデータでしょうか。それとも、データの活用方法でしょうか。
Lin Dahua:まず、2つの概念を区別する必要があります。世界モデルは、世界とその物理法則を学習します。空間知能が注目するのは、人間がどのように空間を理解し、空間の中で思考し、行動するかです。少なくとも空間知能について言えば、世界に動画が不足しているとは思いません。公開動画も一人称視点の動画も非常に多く、私たちのエコシステム企業も一人称データの収集に取り組んでいます。本当の問題は、こうしたデータがまだ十分に活用されていないことです。
データも階層的に利用する必要があります。言語モデルのトレーニングと同じように、事前学習の段階では素材を幅広く吸収し、中期のトレーニングでは特定領域のタスクと推論プロセスを加え、事後学習では具体的なタスクに合わせて調整します。
現在、皆さんは主に動画を使って生成モデルを学習させ、画面がどのようなものか、次のフレームでどのように変化するかを学ばせています。しかし、動画を活用して知能を高めるという点では、まだ十分に活用できていません。例えば映画で、ある人物が何かを見た後、突然恐怖の表情を浮かべる場面があります。モデルはその表情を見るだけでなく、なぜ恐怖を感じているのか、それが起きている出来事とどのような関係にあるのかまで理解しなければなりません。これこそが理解です。
ここには2つの課題があります。1つは、空間知能に適した動画を引き続き収集すること、もう1つは、動画をめぐって適切な問いを立て、出来事同士の関連性を構築することです。後者こそ、現時点でまだ大規模に実現できていないことです。
36Kr:SenseNova U1.5は、画像上で連続的に編集できるようになりました。このアプローチは、動画や3次元へどのように拡張されていくのでしょうか。
Lin Dahua:空間知能の目標から見ると、3次元は動画よりも優先度が高くなる可能性さえあります。空間知能の本質は、3次元の世界を理解し、3次元空間で行動・インタラクションできることです。連続編集とフィードバックループの基本原理は共通していますが、動画や3次元に進むとデータの形態がより複雑になり、新たな問題にも直面します。
この技術の主軸はすでにかなり明確になっており、今後は具体的な問題を一つひとつ解決していくことになります。U2では、より多くの空間知能の要素も取り入れ、3次元空間のモデリングと理解をさらに強化します。静止画を単に動画へ引き延ばすだけではありません。
04
マルチモーダルは「偽のニーズ」ではない。重要なのは、適切な問いを立てること
36Kr:Codingはすでに明確な収益と評価額への反応をもたらしていますが、マルチモーダルの投資回収にはより長い時間がかかるように見えます。SenseTimeは長期的な路線を堅持しながら、同時に段階的な成果をどのように示していくのでしょうか。
Lin Dahua:SenseTimeはCodingをやっていないわけではありません。ただ、複雑なソフトウェアエンジニアリングを主な方向にはしていないのです。私たちは長期的なビジョンを確信し、その実現に向けて、重要な優先事項にリソースを投入してきました。
市場が最終的に見るのは、この路線が顧客と収益を生み出せるかどうかです。SenseTimeは、Raccoon Work(AIオフィスエージェント)などの製品におけるユーザー数の増加、リピート利用、課金を通じて、より大きなモデルを1つ発表するだけではなく、マルチモーダルがビジネスとして成立することを証明する必要があります。
私たちは社内で、1Tパラメータモデルに挑戦するかどうかを議論したことがあります。結論は、技術の法則に基づいて前進し、適切なタイミングで1Tやそれ以上のモデルを開発する、というものでした。ただし、必ず革新的なアーキテクチャと技術に基づいて進めるのであって、単純に規模を拡大し、同質化した競争を行うわけではありません。
できるだけ早く規模を拡大するために、本質的な問題の探究を遅らせることは望んでいません。現在、大規模モデルをめぐる競争は極めて激しく、モデル企業の認識が先行しているか、十分な速さで反復できているかは非常に重要であり、成否を左右する要素です。私たちにとって、パラメータの大きさは具体的な技術上の選択にすぎません。それより重要なのは、自分たちが定めた方向に十分な速さで進み、認識を先行させることです。
具体的には、モデルのパラメータ規模は、技術の道筋がどの程度成熟しているかによって決まります。最先端の探究において、技術の道筋がまだ十分に検証されていない段階で、早すぎるタイミングに大規模なパラメータを採用すると、かえって反復速度を遅らせることになります。道筋が徐々に成熟してきた段階では、Scale Up(モデル規模の拡大)によって能力の上限を探ります。そのため、私たちのマルチモーダルエージェントモデルはすでにScale Up段階に入っていますが、理解と生成を統合するアーキテクチャおよび学習パラダイムについては、なお一連の問題を探究する必要があります。
△SenseTimeのRaccoon Work
36Kr:先ほど、Codingの能力の蓄積がある段階を超えると、皆が突然、本当に使えると感じるようになったとおっしゃいました。デザインと空間知能については、それぞれどのような転換点になるのでしょうか。
Lin Dahua:Codingは突然、以前より数桁も強くなったわけではありません。能力の蓄積がある段階に達し、皆が本当に使いやすいと感じ始めたのです。
デザインの転換点は、そう遠くありません。モデルの制御性とビジュアル品質は継続的に向上しており、次の段階は実際のワークフローに入ることです。例えば、Figmaなどのツールでそのまま継続利用できるコンテンツを直接生成することです。「見栄えが良い」から「使える」へ移行するうえで、多くの問題は、より優れたデータと製品機能によって解決できます。月単位で考えられるのではないかと思います。
空間推論と視覚推論の転換点は、さらに遅れて訪れますが、影響はより深いものになります。空間知能を備えた頭脳がなければ、ロボットは固定された環境で固定された動作を行うことしかできず、複雑な物理空間で長期的なタスクを自律的に完遂するのは困難です。
36Kr:現在、画像生成や動画生成の利用料金は下がり続けていますが、プロフェッショナル顧客の利用シーンでは、最終的な納品物の品質がより重視されています。マルチモーダルは価格競争に向かうと思いますか。
Lin Dahua:皆が同じ水準の能力にあるなら、ユーザーは当然、より安価なモデルを選びます。しかし、Tokenだけをめぐって競争すれば、利益率は非常に低くなり、モデルは最終的に電気・水道・ガスのようなコモディティになってしまいます。
人工知能が電気・水道・ガスのような存在になるという考えには同意しますが、電気・水道・ガスは、この時代に最も収益性の高い業界ではありません。本当に価値があるのは、最終的にユーザーのどのような問題を解決したかです。
弁護士は判決文の文字数に応じて料金を請求するわけではなく、医師も診療記録の文字数に応じて料金を請求するわけではありません。訴訟に勝つこと、病気を治すこと。ユーザーが料金を支払うのは、その結果に対してです。知能は重量単位で売るものではありません。Tokenは単なる計量単位にすぎず、最終的には解決した問題にどれだけの価値があるかが重要です。
将来的には、タスク単位や最終納品物単位で課金することもできますし、人工知能と顧客が共同で業務を遂行し、その結果を分配することもできます。ユーザーが気にするのは、モデルが1Mまたは100M Tokensを消費したかどうかではなく、物事が成し遂げられたかどうかです。
36Kr:Codingがいち早く商業的な収益を生み出した後、一部のマルチモーダル分野の研究者は自らを「CV(コンピュータービジョン)難民」と呼んでいます。このような方向性への不安をどう見ていますか。
Lin Dahua:理解できます。Codingが注目されれば、人材の価格も当然高くなり、皆が影響を受けます。しかし、異なる分野が商業化に成功する時期には、もともと先後があります。
2022年以前、自然言語処理には今日のような商業的価値はありませんでした。当時、インテリジェントカスタマーサービスに取り組むのは非常に大変で、大量のカスタマイズが必要でした。そのため、顔認識など、少なくとも大規模な商用化が可能になっていた分野があるコンピュータービジョンに戻ったほうがよいと考える人もいました。今日、単にCodingが、商業的な将来性が非常に明確な段階に先に到達したということです。
これは株式投資に少し似ています。現在、Codingは最も速く上昇している銘柄の1つですが、だからといって、誰もが資金のすべてを、ましてや人生までもそこに賭ける必要はありません。人工知能が変えるのはCodingだけではありません。誰もが自分の蓄積と判断に基づいて、本当に信じられるものを選ぶべきです。
もちろん、マルチモーダルを選ぶ場合も、過去の路線を繰り返してはなりません。率直に言えば、従来のVLM(視覚言語モデル)の基本的なパラダイムは、すでに行き詰まりに達しています。今日マルチモーダルについて語る際に、依然としてVQA(ビジュアル質問応答)を行い、画像に何が写っているかを答えるだけであれば、技術的価値も商業的価値もそれほど大きくありません。
36Kr:より多くの企業にネイティブ・マルチモーダルへの投資を促しますか。
Lin Dahua:私がより強く伝えたいのは、皆さんがマルチモーダルの長期的な将来性に自信を持つべきだということです。多くの業界では、視覚能力への需要は根強いものがあります。マルチモーダルは「偽のニーズ」ではありません。ただし、適切な問いを立てる必要があり、単純なビジュアル質問応答にとどまり続けてはいけません。
各企業や各従事者がCodingとマルチモーダルのどちらを選ぶかについて、生まれつきの優劣があるわけではありません。重要なのは、自分の蓄積と判断に基づき、単純に流行を追うのではなく、本当に信じられる方向を選ぶことです。
36Kr:今後1〜2年で、マルチモーダルにもCode Agentの急成長に似た重要な転換点が訪れるでしょうか。
Lin Dahua:現段階では、Codingの意義はCodingそのものを超えています。人工知能が本当に仕事をこなし、商業的価値を生み出せることを、詩を書いたり絵を描いたりするだけではない形で、皆に示しました。これは業界全体に大きな自信をもたらしました。
今後1〜2年で、マルチモーダルも同様の転換点を越えるのではないかと思います。最終的に現れる形は、今日の製品とは異なる可能性があります。必ずしも画像生成や動画生成のツールだけとは限りませんが、その核となるのは、視覚、言語、推論、行動の融合です。
データとアプリケーションが継続的に成熟するにつれて、マルチモーダルには能力が創発する瞬間が訪れるでしょう。もちろん、SenseTimeがいち早くこの段階に到達することを望んでいます。
画像提供|IC photo