




 リターンマッチ
- ニュース
【技術ブログ】より大きなパラメータから、より深い計算へ:Looped MMDiTによる画像生成のScaling探索
最近、GPT-6をめぐる議論によって、「循環Transformer」「循環深度」が再び注目を集めています。Transformerは、より多くのパラメータや層を積み重ねなければ、より高い能力を得られないのでしょうか。
具体的なアーキテクチャはまだ公開されていないため、ここではGPT-6自体の実装については論じません。しかし興味深いことに、これに似た計算の考え方について、私たちはすでに画像生成モデルで独自に検証を進めています。
今年4月頃、私たちはLooped MMDiTの開発に着手しました。
当時、私たちが注目していたのはGPT-6ではなく、テキストから画像を生成するモデルにおけるスケーリングコストの増大でした。モデルが大規模化するほど、ストレージ、GPUメモリ、学習時の通信、デプロイのコストも増加します。単に「より大きなモデル」を追求するのではなく、Looped MMDiTが答えようとしたのは、別の問いでした。モデルは単に「大きく」するだけでなく、「深く」することもできるのでしょうか。
01「モデルをより大きく」から「モデル内部の計算をより深く」へ
過去数年、スケーリングの最も直感的な方法は、パラメータを増やすことでした。より大きなモデル、より広い隠れ次元、より多くのTransformer layersです。しかし、パラメータ規模と計算の深さは、必ず結び付いていなければならないのでしょうか。Looped Transformerは、別の可能性を示します。

図1|元のMMDiTとNaive Looped MMDiT:中央のLooped Blocksはパラメータを共有し、繰り返し実行される。
従来のTransformerで深さを増やす場合、通常は新たなパラメータを追加する必要があります。一方、Looped Transformerは1組のblocksを再利用し、Loop Depthを増やすことで、隠れ状態により多くの計算を繰り返し適用します。
この考え方に基づき、私たちは画像生成におけるLoopingの3つの可能性をさらに検証しました。
1つ目は、パラメータの再利用によってパラメータ効率を高め、比較的小さなパラメータ規模でより深い計算を実現し、大規模モデルに匹敵する性能を獲得することです。
2つ目は、隠れ状態を潜在空間内で継続的に反復させ、明示的なCoTに依存しない内部計算を実現することです。
3つ目は、同じ推論計算予算の下で、より多くの計算をLoop Depthに振り向け、ノイズ除去ステップ数を増やす場合よりも高い性能向上を得ることです。
02Diffusionはすでに何度も計算しているのになぜさらにLoopするのか?
テキストから画像を生成するモデルの特殊性は、もともと反復処理を行う点にあります。Diffusion/Flowモデルは、複数のノイズ除去ステップを通じて、ノイズから徐々に画像を生成します。私たちの方法は、1回のノイズ除去ステップの内部にLoopを配置するものです。
これにより、モデルには独立して調整可能な2つの計算次元が生まれます。外部にはノイズ除去ステップ数、内部にはLoop Depthがあります。ここで本当の問題となるのは、同じInference Computeの下で、計算資源をより多くのノイズ除去ステップに費やすべきか、それともより深いLoopに費やすべきか、ということです。
これは、Looped MMDiTと、現在GPT-6をめぐって公開されている循環深度の議論との最も重要な違いの1つでもあります。後者が議論しているのは、自回帰生成で次のTokenを生成する前の内部計算です。一方、私たちの研究はDiffusion/Flowによるテキストから画像を生成するモデルを対象とし、1回のノイズ除去ステップ内で循環深度を増やします。GPT-6の具体的な循環アーキテクチャについては、現時点で公開情報が不足しているため、これ以上詳細な構造比較は行いません。
03私たちはすぐに気付きました。Naive Loopは単純ではない
最も直接的な方法は、MMDiTの中央にある1組のblocksを取り出し、N回繰り返し実行することです。私たちはまずこのNaive Looped MMDiTを試しましたが、実験によってすぐに、Loopは深ければ深いほどよいわけではないことが明らかになりました。

図2|学習時に4回のLoopを使用した場合の、異なるinference Loop Depthにおける性能:学習時の深さに近づくと向上効果はすぐに飽和し、さらに深くすると性能が低下する。
実験から、次のことが分かりました。
Inference Loop Depthが浅い場合、Basic Naive Loopは元のMMDiTを下回ることが多い。
Loop Depthを増やすと性能は向上しますが、すぐに飽和する。
Loop Depthが学習時に使用した深さを超えると、性能は概して低下する。
言い換えれば、Loop Depthは「無料のモデル深度」ではありません。
さらに分析を進めた結果、問題は2点に集約されました。中央のLoop出力に有効な教師信号が不足していること、そして隠れ状態を繰り返し更新することで、Tokenの局所情報が徐々に損なわれることです。
04Loopが深くなるほど、モデルは「物体がどこにあるか」を把握できなくなる可能性がある
2つ目の問題を理解するため、私たちはProbeを実施しました。各Loop後の隠れ状態からリッジ回帰によってTokenの位置を予測し、決定係数R²を用いて位置の予測可能性を評価しました。

図3|Loop passの増加に伴い、位置予測のR²は継続的に低下し、局所的な位置情報が徐々に損なわれていることを示している。
この現象は、画像生成において特に重要です。物体の左右・上下の関係や属性のバインディングは、局所構造に依存しています。私たちは、Loopによってより深いグローバルな計算と組み合わせ推論を実現したい一方で、反復処理によって隠れ状態の局所情報が「洗い流される」ことは避けなければなりません。そこで、Loop自体を再設計する必要がありました。
053つの重要な要素:すべてのLoopを真に有効にする
Loopingの核心的な課題は、1つのモジュールを単純に何度も繰り返すことではなく、各反復が真に有効な計算を生み出すようにすることです。そこで私たちは、Deep Supervision、Loop Distillation、Self-Modulating Attention(SMA)を導入しました。前者2つは中間Loopの教師信号の問題を解決し、SMAは深いLoopにおける局所表現の劣化に対処します。
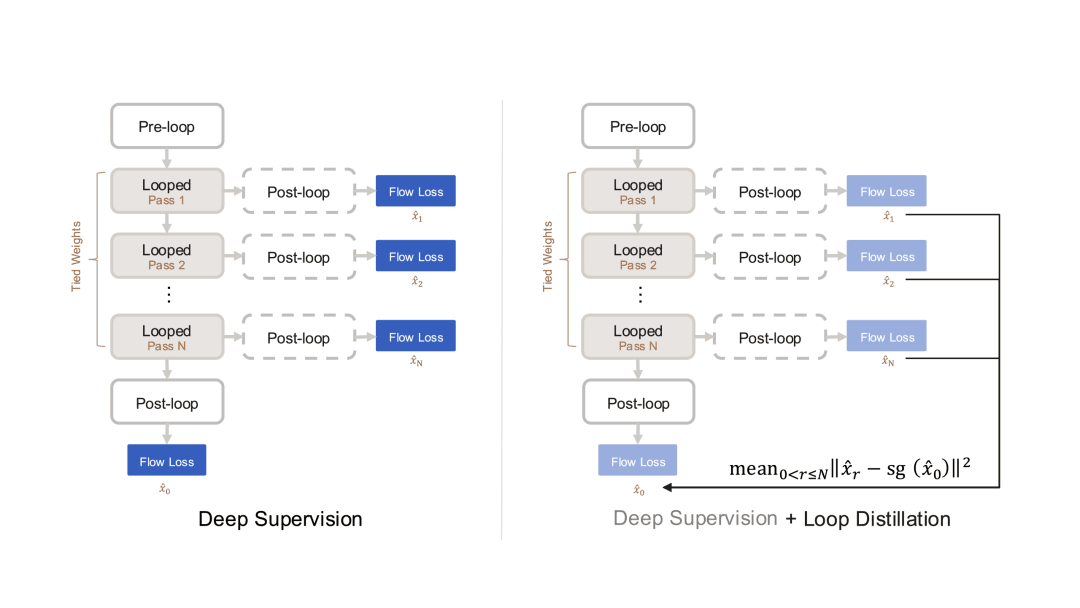
図4|Deep SupervisionとLoop Distillation:各中間予測に直接的な教師信号を与え、浅いLoopを最終予測にアライメントさせる。
Deep Supervision:各ラウンドで生成目標に直接向き合う
各Loopの中間予測に対して、最終出力と同じFlow Lossを適用しました。これにより、中間状態は最終出力へ至る単なる「中継層」ではなくなり、各ラウンドで生成目標に向けて直接最適化されます。
Loop Distillation:「少ないラウンドしか考えない自分」に「より多くのラウンドを考えた後の自分」を学習させる
最終Loopの予測をStop-Gradient Teacherとして使用し、それ以前の各ラウンドの予測が最終結果に近づくよう制約しました。これにより、浅いLoopでもより早く最終予測に近づけるようになります。
さらに、教師信号の問題を解決した後は、Attentionを繰り返し更新することで生じる局所情報の損失も制御する必要があります。そこで私たちはSelf-Modulating Attention(SMA)を設計しました。
Self-Modulating Attention:毎回「これほど大きく」変更する必要はない
SMAの核心は、Ordinary Attention Outputを現在のToken自身のValue方向と直交する空間に射影し、Self-attention信号を利用して入力依存のModulation Coefficientを形成することで、更新幅をTokenと現在の状態に応じて動的に変化させることにあります。
直感的に言えば、通常のAttentionは「他のTokenが私に何を伝えたのか、それを受けてどう更新すべきか」に重点を置きます。一方、SMAはさらに「このラウンドで、果たしてどの程度更新する必要があるのか」と問いかけます。同じblockを何度も繰り返し実行する場合、この適応的な更新制御は特に重要です。
Deep Supervision、Loop Distillation、SMAを組み合わせて初めて、より深いLoopによるメリットが実際に引き出されることが分かりました。Looped MMDiTは、単に「MMDiTを何度も実行する」ものではありません。反復計算を、安定して学習・活用できる計算軸へと変えるものです。
06発見1Loopingによって、パラメータのScalingをより効率化
これらの設計を完了した後、まずパラメータ効率を検証しました。Looped MMDiT Backboneはわずか260Mパラメータですが、GenEval、DPG Bench、PRISM、CoRe、Spatialなどの評価ベンチマークにおいて、実験で用いた約4倍のパラメータ規模を持つ大規模モデルのベースラインを、複数の指標で上回りました。

図5|パラメータ効率の比較:260MのLooped MMDiTは、複数の指標でより大規模なパラメータベースラインを上回る位置にあります。

表1|主な実験結果。
私たちがより重視しているのは、「小規模モデルが大規模モデルに勝った」こと自体ではありません。この結果が、より基本的な見方を裏付けたことです。モデルが持つパラメータ数と、モデルが実行できる計算の深さは、必ずしも同じ割合で増加する必要はありません。パラメータを再利用することで、Loop Depthによって実効的な計算の深さを高めることができます。
07発見2Loopingによって、計算を潜在空間で実行
研究をさらに進める中で、Loopingの価値はパラメータ効率だけにとどまらない可能性があることが分かりました。画像生成における複雑な物体の組み合わせ、属性のバインディング、仮説関係、空間関係は、明示的なCoTで表現するのが必ずしも適しているとは限りません。そこで私たちは、画像モデルがReasoningを記述することなく、隠れ状態の中で「思考」できるのかに注目しました。

図6|Prompt Rewriteと比較して、Loopingは組み合わせ推論、PRISM、空間関係タスクでより大きな向上を示します。

図7|reasoning trainingを行ったCoT+T2I手法との比較。Looped MMDiTは複数のbenchmarkでより良い結果を達成しました。
これらの結果から、私たちはLoopingをLatent-space Reasoningのメカニズムの一種と捉えるようになりました。追加でReasoning Tokensを生成するのではなく、視覚的な隠れ状態を多ラウンド反復することで、内部計算の深さを高めます。
08発見3Loopingによって、推論計算をより柔軟に
画像生成には現在、2種類の反復処理があります。そこで私たちは、2種類のInference Computeの配分方法を比較しました。ノイズ除去ステップ数を増やす方法と、Loop Depthを増やす方法です。

図8|同じ推論計算予算の下で、より多くの計算をLoop Depthに配分すると、ノイズ除去ステップ数を増やす場合よりも高い性能向上が得られます。
私たちの実験設定と同じInference Compute Budgetの下では、ノイズ除去ステップ数(Denoising Steps)を増やすよりも、より多くの計算をLoop Depthに配分する方が効果的でした。これは、生成に必要なIterative Computationの一部が、モデル外部のDenoising Processにおけるノイズ除去で必ずしもすべて実行される必要はなく、モデル内部に取り込まれ、エンドツーエンドで学習可能な反復計算になり得ることを意味します。
この方向性が今後も有効であるなら、さらに踏み込んだ問いが自然に導かれます。ノイズ除去ステップ数を減らしながら、より深いLatent-space Computationによって生成能力を維持、あるいは向上させることはできるのでしょうか。さらに一歩進めれば、シングルステップ生成にも思い至ります。現時点で、そこまで到達したとはまだ言えません。しかし、この道筋は今後も探究する価値があります。
さらに興味深いことに、Loopingがもたらす可能性は、計算をより深くすることだけではありません。クロスLoopの自己修正能力(Self-Correction Between Loops)も考えられます。前のラウンドで生成された結果は終点ではなく、モデルは後続のLoopで現在の状態に基づいて調整と修正を続けることができます。

図9|Self-Correction Between Loops
Prompt: 5つの赤い風船を持つ、2体のおもちゃの象を描いた、遊び心のある3Dレンダリング。
09私たちはScalingパラダイムの変化を目の当たりにしているのかもしれません
これらの実験を終えて、私たちはLoopingを、より大きなScalingの全体像の中で捉える価値があるとますます感じるようになりました。
これまで、モデルの能力を高めるために、主に2つの軸に沿って拡張が進められてきました。パラメータ数を増やすことと、Inference-time Tokensを増やすことです。
Looped MMDiTは、第三の軸の可能性を示しています。それは、より深い潜在空間計算です。
モデルは、パラメータを同じ割合で増やすことで、より深い計算を実現する必要はありません。また、より多くの推論過程を明示的なReasoning Tokensとして展開する必要もありません。同じパラメータセットを繰り返し呼び出すことで、隠れ状態を潜在空間内で継続的に反復させ、推論計算の予算に応じて実効的な計算の深さを柔軟に調整できます。
私たちにとって、これはLooped MMDiTにおける一つの実験的な結論にとどまりません。私たちは、より効率的なLoopedアーキテクチャの探究にも積極的に取り組んでいます。この方向性の探究は、将来のSenseNovaモデルシリーズのアーキテクチャ基盤となり、ネイティブマルチモーダルの継続的なブレークスルーを後押しすることが期待されます。今後もLatent-space Inference-time Scalingの探究を続け、パラメータ数や明示的な推論Tokenを同じ割合で増やすことなく、より深い内部計算によって、複雑な組み合わせ、仮説推論、空間関係推論などの能力を高めていきます。
過去数年におけるScalingの最も重要な問いの一つが「モデルはどこまで大きくできるのか」だったとすれば、これから真剣に答える価値のあるもう一つの問いは、「同じパラメータセットで、果たしてどこまで深く計算できるのか」なのかもしれません。
私たちは今、まだ第一歩を踏み出したにすぎません。現時点では、小規模な実験によってこの道筋の実現可能性を検証しています。今後は、このメカニズムをSenseNova Uシリーズの統合生成・理解フレームワークにさらに組み込み、より大規模な環境でLoopメカニズムの有効性を継続的に検証していきます。
Looped MMDiTの研究成果は、9月末にもオープンソースとして公開される予定です。その際には、より詳細な技術情報と実験結果を共有します。また、Loop Depthがパラメータ規模とInference-time Token Budget以外に、生成モデルにおけるもう一つの有効なScaling軸となり得るのか、コミュニティの皆さまとともに検証を続けていきたいと考えています。